Планування / Впровадження
Анотація
У цьому документі наведено результати тестування продуктивності та рекомендації щодо розгортання малих мовних моделей (Small Language Models, SLM) на серверах Lenovo ThinkAgile HX V4 і FX V4 із процесорами Intel Xeon 6 та програмним забезпеченням Nutanix без необхідності використання спеціалізованих GPU-платформ. Для тестування використовувалася модель Microsoft Phi-3 Mini 128K Instruct, оптимізована за допомогою Intel OpenVINO. Документ охоплює формати точності INT4, INT8 і FP16, а отримані результати використовуються для формування рекомендацій щодо визначення необхідних ресурсів і схем розгортання для інтерактивних, потокових і спільних сервісів, а також робочих навантажень, орієнтованих на максимальну пропускну здатність.
Документ призначений для ІТ-архітекторів, інженерів з інфраструктури та технічних фахівців, які ухвалюють рішення й оцінюють можливості локального розгортання генеративного ШІ. Передбачається, що читачі мають практичні знання гіперконвергентної інфраструктури, віртуалізації серверів та основних принципів інференсу великих мовних моделей (LLM).
Вступ
Використання генеративного ШІ стрімко поширюється серед великих підприємств і компаній малого та середнього бізнесу, які шукають практичні способи підвищити продуктивність, автоматизувати робочі процеси, пов’язані з опрацюванням знань, створювати стислий виклад бізнес-контенту та розгортати ШI-помічників поруч із корпоративними даними. Малі мовні моделі (SLM) дають змогу реалізувати ці можливості на сучасній інфраструктурі на базі CPU, зменшуючи залежність від спеціалізованих GPU-платформ і водночас зберігаючи простішу та економічно ефективнішу операційну модель.
Цей технічний документ визначає перевірені архітектурні підходи та основу для розгортання малих мовних моделей (SLM) на CPU-інфраструктурі на базі серверів Lenovo ThinkAgile HX V4 і FX V4 із програмним забезпеченням Nutanix та процесорами Intel Xeon 6. Результати тестування покладено в основу масштабованих схем розгортання та практичних рекомендацій щодо визначення необхідних ресурсів, які допомагають малим і середнім підприємствам (SME) знаходити оптимальний баланс між затримкою та пропускною здатністю для корпоративних сценаріїв використання.
У протестованій архітектурі розгортання малих мовних моделей (SLM) оптимізовано завдяки квантованим форматам змішаної точності (INT4/INT8), що виконуються локально в ізольованому середовищі віртуальної машини з прив’язкою до NUMA.
Для підприємств, які розглядають розподілене багатовузлове масштабування нестиснених ваг моделі з використанням нативних актуальних фреймворків доступний додатковий технічний документ: Оптимізація розподіленого інференсу SLM на серверах Lenovo ThinkAgile VX V4 та FX V4 з використанням VMware Cloud Foundation 9.0
Lenovo ThinkAgile HX V4 і FX V4 із процесорами Intel Xeon 6
Lenovo ThinkAgile HX650 V4 і FX650 V4 – це двосокетні системи формфактора 2U, а Lenovo ThinkAgile HX630 V4 і FX630 V4 – двосокетні системи формфактора 1U. Ці гіперконвергентні системи оснащуються двосокетними процесорами Intel Xeon 6 (раніше відомими під кодовою назвою Granite Rapids). Гіперконвергентні системи ThinkAgile HX V4 і FX V4 призначені для розгортання провідного програмного забезпечення Nutanix для гіперконвергентної інфраструктури на корпоративних платформах Lenovo.
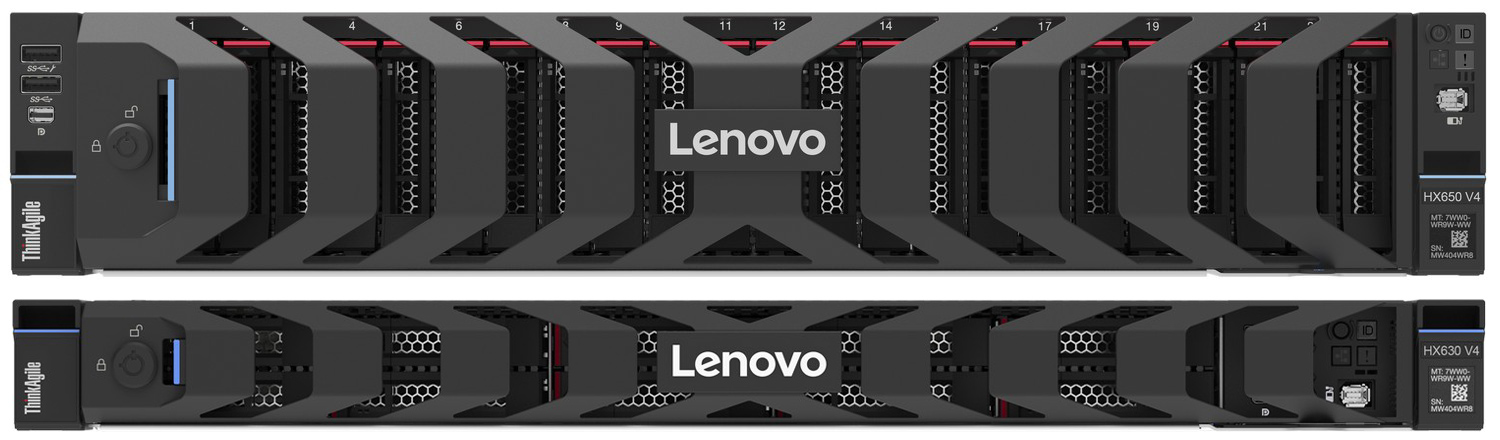
Рисунок 1. ThinkAgile HX650 V4 (угорі) і HX630 V4 (унизу), розроблені для гіперконвергентної інфраструктури Nutanix
Nutanix Cloud Platform (NCP) забезпечує переваги хмарного масштабу для корпоративних застосунків і баз даних, поєднуючи ThinkAgile HX V4 і FX V4 з інфраструктурою публічної хмари. Платформа пропонує надійне корпоративне зберігання даних, інтегрований захист даних, вбудовану відмовостійкість, уніфіковане керування, розширену аналітику, комплексний наскрізний захист і стабільну продуктивність для критично важливих робочих навантажень.
ThinkAgile FX пропонує унікальну для галузі гнучкість програмно-визначеного підходу до гіперконвергенції. Можливість переходити між обраними гіпервізорами дає змогу об’єднати обчислювальні ресурси, зберігання даних і керування в тісно інтегрованому програмному стеку, а також захистити інвестиції в довгостроковій перспективі завдяки безперешкодному переходу між програмними рішеннями HCI.
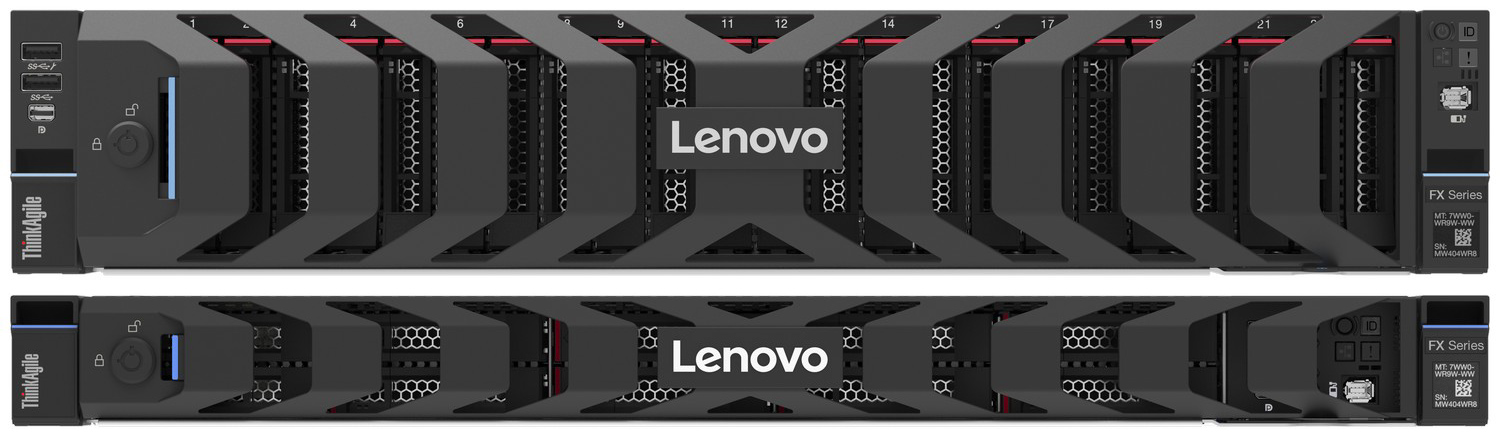
Рисунок 2. ThinkAgile FX650 V4 (угорі) і FX630 V4 (унизу), розроблені для гнучкої гіперконвергентної інфраструктури
Конфігурація обладнання
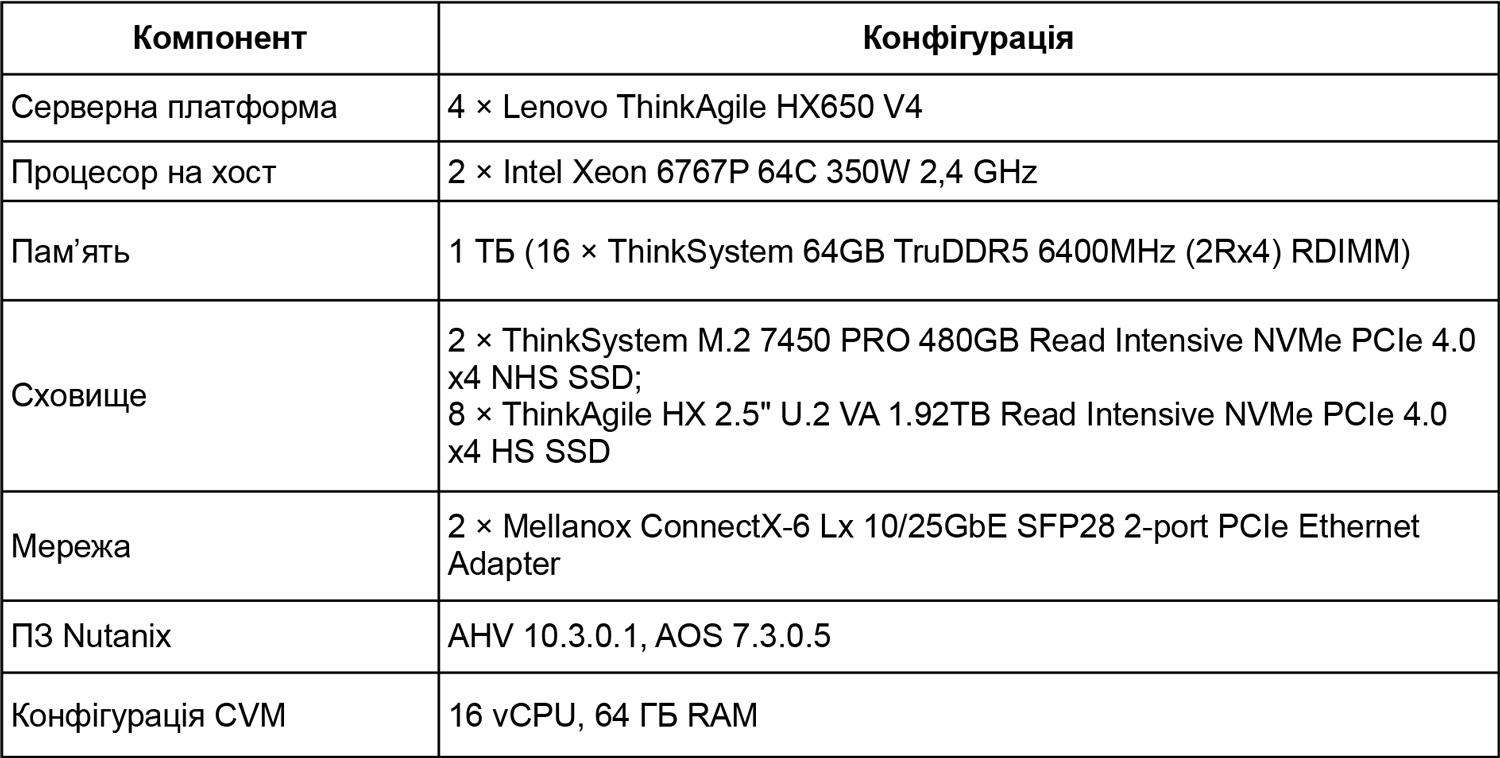
Апаратна конфігурація відображає типовий сценарій розгортання для малого та середнього бізнесу, у якому інференс генеративного ШІ може виконуватися на системах Lenovo ThinkAgile HX/FX V4 із Nutanix і процесорами Intel Xeon 6.
Таблиця 1. Конфігурація кластера Lenovo ThinkAgile HX650 V4
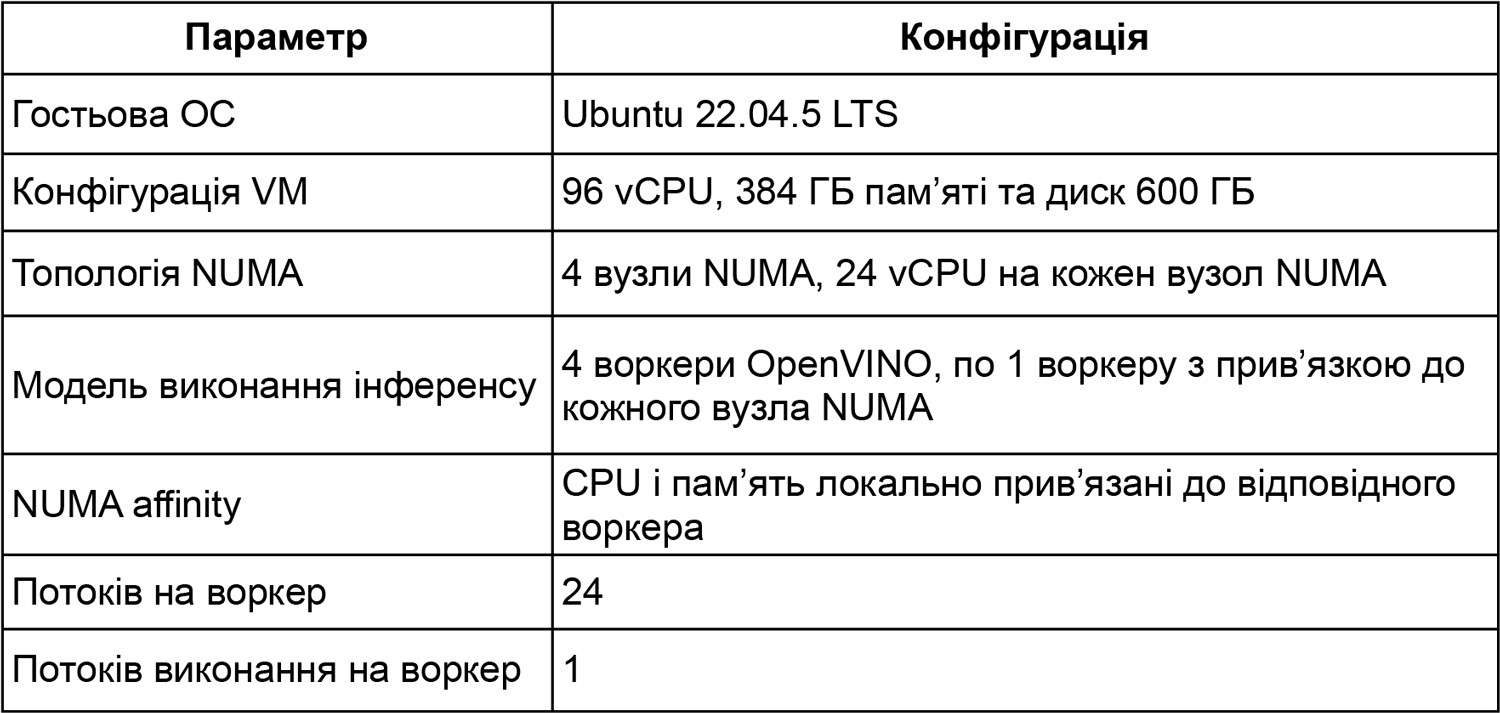
Нижче наведено конфігурацію віртуальної машини.
Таблиця 2. Конфігурація віртуальної машини
Конфігурація програмного забезпечення
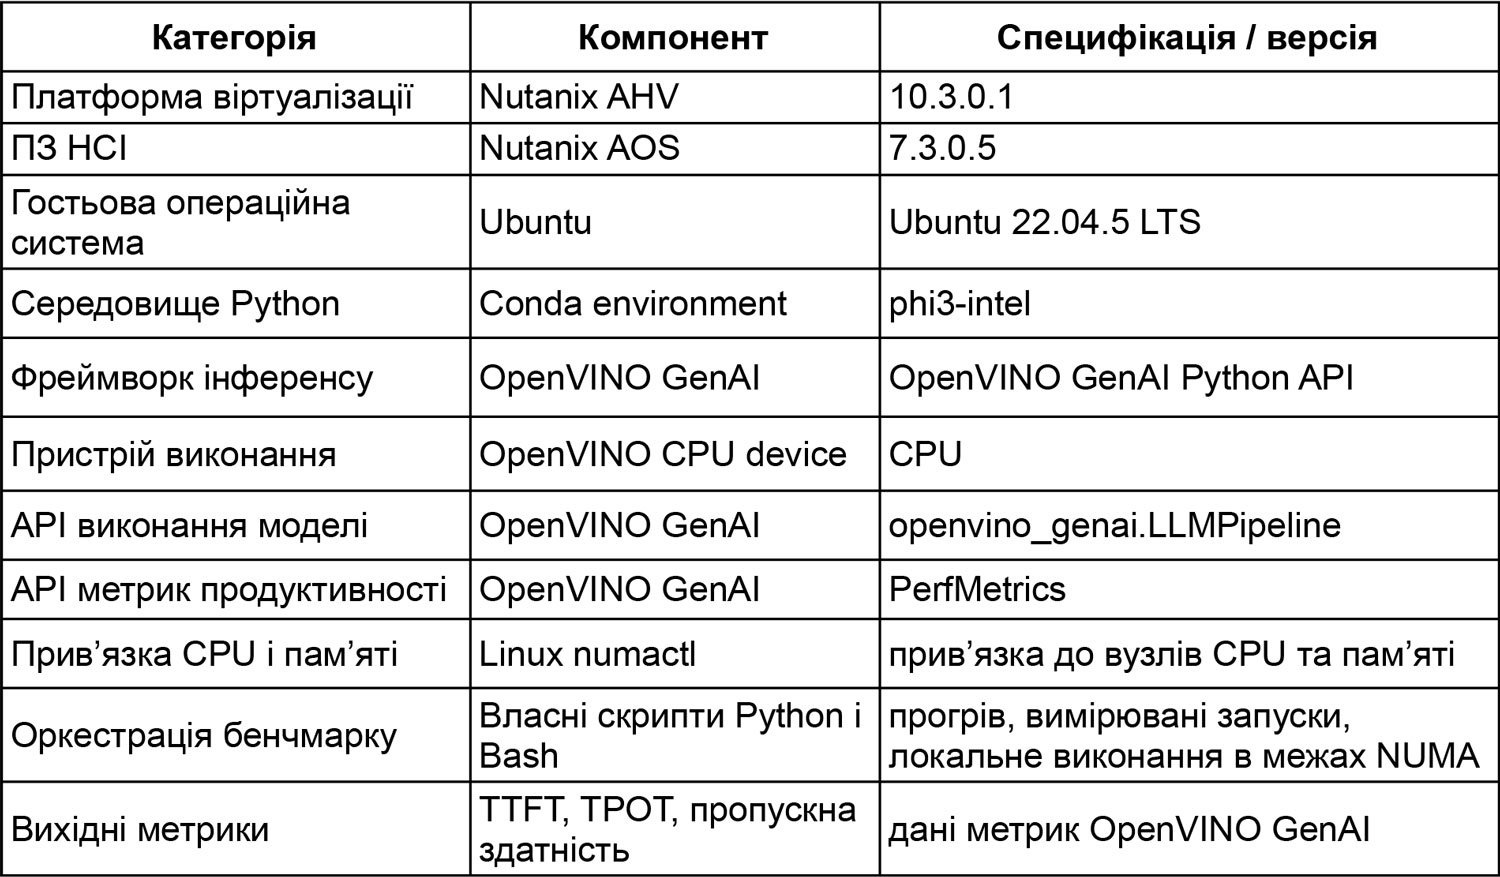
Стек інференсу базувався на OpenVINO GenAI, який надає оптимізовані конвеєри генеративного ШІ для виконання інференсу на CPU на апаратному забезпеченні Intel.
Таблиця 3. Конфігурація програмного забезпечення
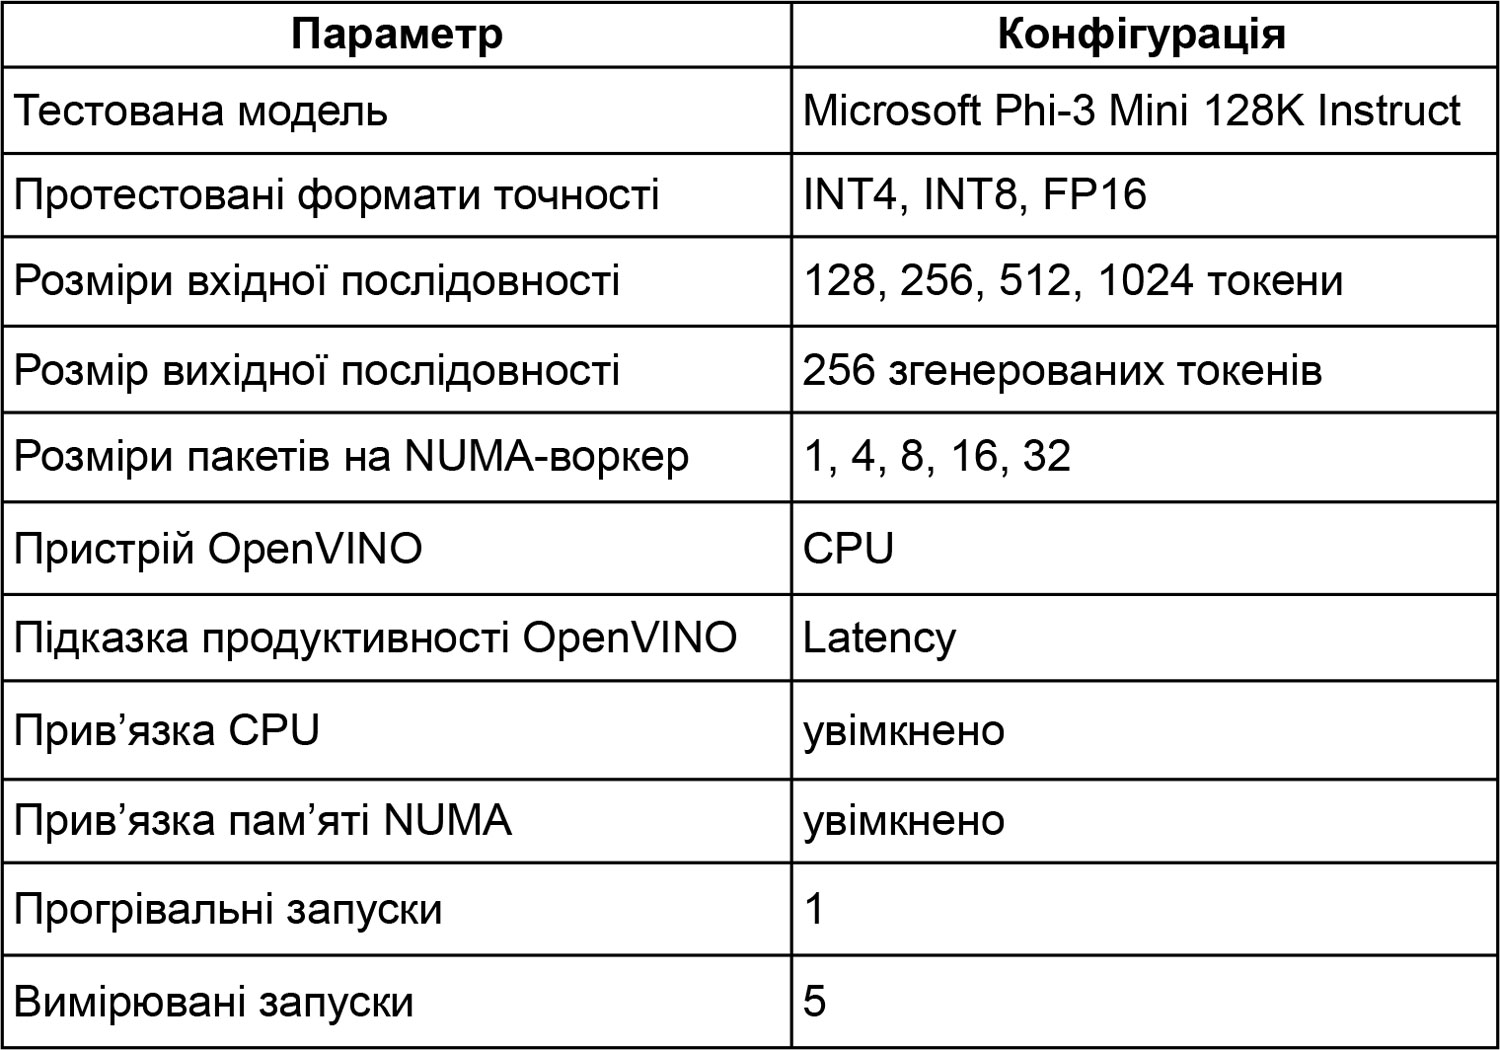
Таблиця 4. Конфігурація моделі та середовища виконання
Методологія тестування
Для цієї перевірки використовувався фреймворк інференсу OpenVINO GenAI, який надає оптимізовані конвеєри генеративного ШІ поверх OpenVINO Runtime. OpenVINO GenAI надає API LLMPipeline для запуску мовних моделей на таких пристроях, як CPU, а також вбудовані метрики продуктивності через PerfMetrics (openvinotoolkit.github.io). Для тестування було обрано Microsoft Phi-3 Mini 128K Instruct – малу мовну модель із сімейства Microsoft Phi-3 (huggingface.co), придатну для таких сценаріїв, як робота з корпоративними знаннями, створення стислих викладів, взаємодія з документами та автоматизація робочих процесів.
У результатах загальна пропускна здатність підсумовується для чотирьох воркерів, оскільки кожен із них генерує токени незалежно. Значення TTFT і TPOT не підсумовуються: вони розглядаються як показники швидкості відгуку окремого воркера за паралельного виконання. Такий підхід дає змогу відокремити загальну продуктивність системи від характеристик затримки окремого запиту.
Конфігурація бенчмарку
Для кожної тестової точки запускали чотири незалежні воркери OpenVINO GenAI, по одному на кожен вузол NUMA. Кожен воркер використовував 24 потоки інференсу, один потік виконання, один прогрівальний запуск і п’ять вимірюваних запусків.
Прогрівальний запуск використовувався для зменшення впливу холодного старту перед збиранням результатів вимірювань. Наведені значення є середніми за п’ять вимірюваних запусків після одного прогрівального запуску.
Під час бенчмарку збирали такі метрики OpenVINO GenAI PerfMetrics:
-
TTFT (Time to First Token, час до отримання першого токена) показує, наскільки швидко генерується перший токен; ключовий показник швидкості відгуку в інтерактивних сценаріях, тобто затримки до початку відповіді. Метрика отримується через PerfMetrics API OpenVINO GenAI для одного пакетного виклику g e n e r a t e (). Емпірична перевірка підтвердила, що етап prefill виконується паралельно для всього пакета: фактичний час до завершення генерації першого токена для всіх послідовностей відповідає наведеному середньому TTFT із відхиленням у межах 1% для Batch 32, найбільшої протестованої конфігурації. Це підтверджує, що TTFT відображає фактичну затримку до першого токена для окремого запиту.
-
TPOT (Time per Output Token, час на один вихідний токен) характеризує стабільну швидкість генерації після першого токена, тобто швидкість потокової генерації. Показник відображає сукупну ефективність пропускної здатності воркера в паралельному конвеєрі обробки. Затримка потокової генерації для окремого користувацького запиту всередині пакета розраховується як Batch Size × System TPOT.
- Throughput (пропускна здатність) – кількість згенерованих токенів за секунду.
- Generate duration (тривалість генерації) – час генерації моделлю фіксованої відповіді обсягом 256 токенів.
Метою було виміряти максимальну пропускну здатність і визначити, як точність моделі, розмір пакета, довжина вхідної послідовності та локальне виконання в межах NUMA впливають на швидкість відгуку й загальну продуктивність системи.
Результати аналізуються з огляду на такі архітектурні сценарії розгортання ШI-моделей:
-
Інтерактивні сценарії (двостороння розмова з користувачем у реальному часі) – наднизький TTFT і передбачуваний час виконання бенчмарку.
-
Потокові сценарії (безперервне одностороннє надходження або виведення даних) – низький TPOT і стабільна генерація.
-
Спільні сервіси (максимальне використання інфраструктури та зниження витрат) – баланс між затримкою та сукупною пропускною здатністю.
-
Навантаження, орієнтовані на пропускну здатність – максимальний обсяг обробки, максимальна пропускна здатність системи та ефективність пакетної обробки.
Результати тестування та аналіз
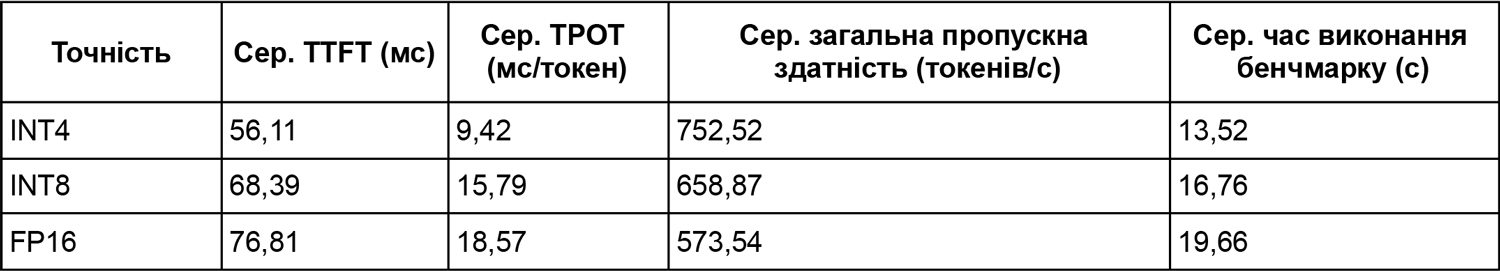
У межах усієї матриці робочих навантажень INT4 продемонстрував найвищу загальну продуктивність інференсу Phi-3 на CPU за показниками Time to First Token (TTFT), Time per Output Token (TPOT) і загальної пропускної здатності системи.
Основний компроміс полягає в тому, що збільшення розміру пакета підвищує сукупну пропускну здатність і покращує TPOT, але водночас збільшує TTFT і загальний час до завершення формування відповіді.
Пропускна здатність
У наведеній нижче таблиці показано, що для тестового сценарію, найбільш чутливого до затримки, INT4 забезпечив найшвидший початок відповіді, найвищу швидкість стабільної генерації токенів і найбільшу загальну пропускну здатність. INT4 продемонстрував найкращий баланс між швидкістю відгуку, стабільною швидкістю генерації та загальною пропускною здатністю системи. INT8 залишався придатною альтернативою зі стисненням, однак у цьому бенчмарку не перевершив INT4. FP16 продемонстрував найнижчу пропускну здатність і найповільнішу стабільну генерацію для цього робочого навантаження, тому цей формат доцільніше розглядати як еталонну конфігурацію з вищою точністю, а не як стандартний варіант для максимальної продуктивності.
У таблиці наведено математичні середні значення для всіх протестованих розмірів пакетів і довжин вхідних послідовностей, щоб показати загальні закономірності масштабування пропускної здатності для форматів FP16, INT8 та INT4. Ці показники не відображають профіль якогось одного робочого пакета.
Таблиця 5. Зведені показники форматів точності для повної матриці виконання (порівняння форматів)
Наступні два графіки показують, що INT4 забезпечив найнижчий середній TTFT і найвищу пропускну здатність у межах усієї матриці робочих навантажень, що свідчить про найменшу затримку до початку відповіді.
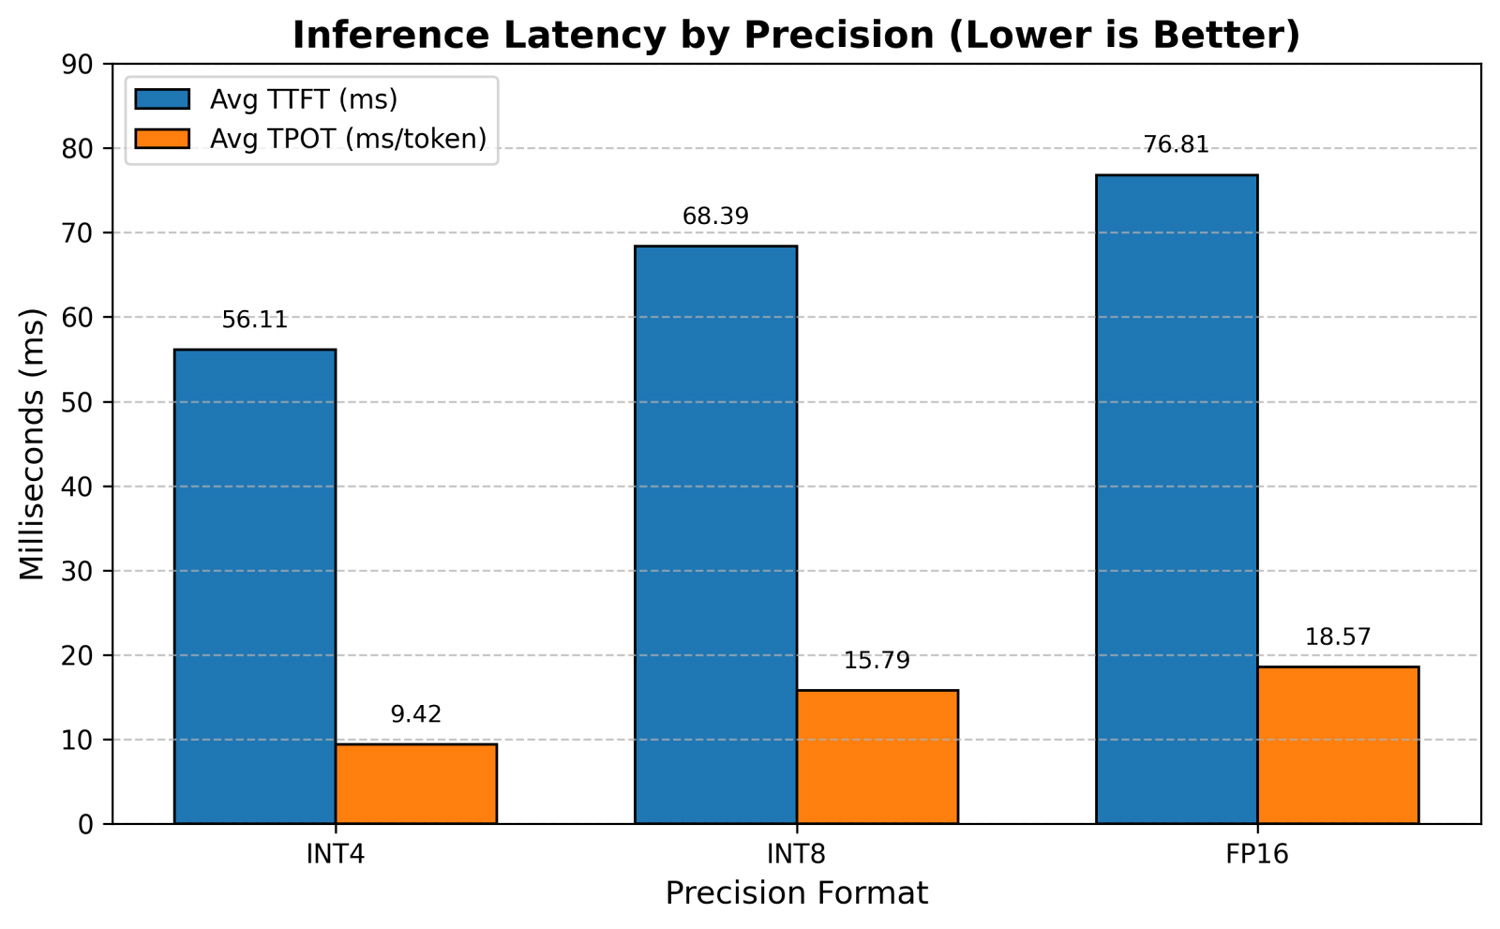
Рисунок 3. Затримка інференсу залежно від формату точності (нижче значення — краще)
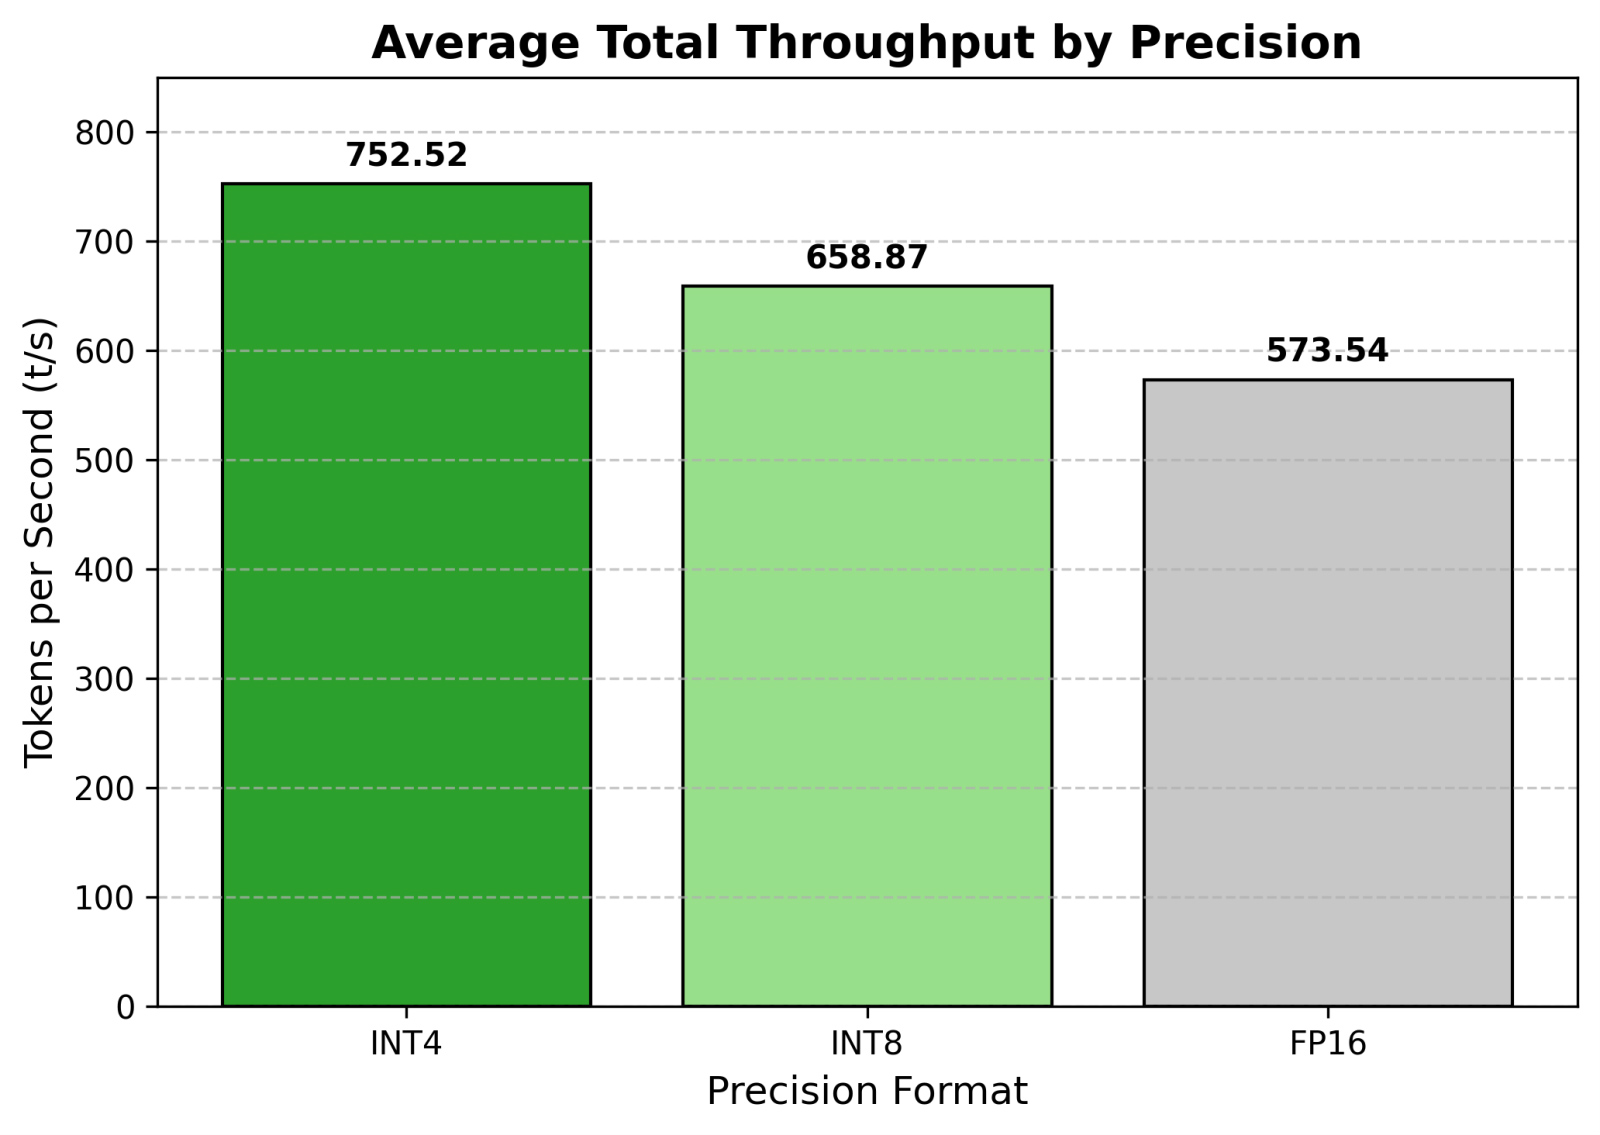
Рисунок 4. Середня загальна пропускна здатність залежно від формату точності
Розмір пакета
Збільшення розміру пакета впливає як на загальну пропускну здатність системи, так і на затримку в усіх протестованих форматах точності. Зі збільшенням розміру пакета загальна пропускна здатність різко зростала, а TPOT зменшувався, що свідчить про підвищення ефективності стабільної генерації токенів. Водночас TTFT збільшувався: більші пакети підвищували пропускну здатність системи, але збільшували затримку до початку відповіді.
Наведені нижче таблиця та графік демонструють, що зі збільшенням розміру пакета TTFT зростає, тобто конфігурації з вищою пропускною здатністю мають більшу затримку до початку відповіді. INT4 зберігає найнижчий TTFT у всьому протестованому діапазоні розмірів пакетів, тоді як INT8 і FP16 демонструють вищу затримку. TPOT зі збільшенням розміру пакета зменшується, що свідчить про підвищення ефективності стабільної генерації токенів за вищого рівня паралельного виконання. INT4 зберігає найнижчий TPOT у всьому протестованому діапазоні, далі йдуть INT8 і FP16.
Таблиця 6. Продуктивність за різних розмірів пакета при 128 вхідних токенах
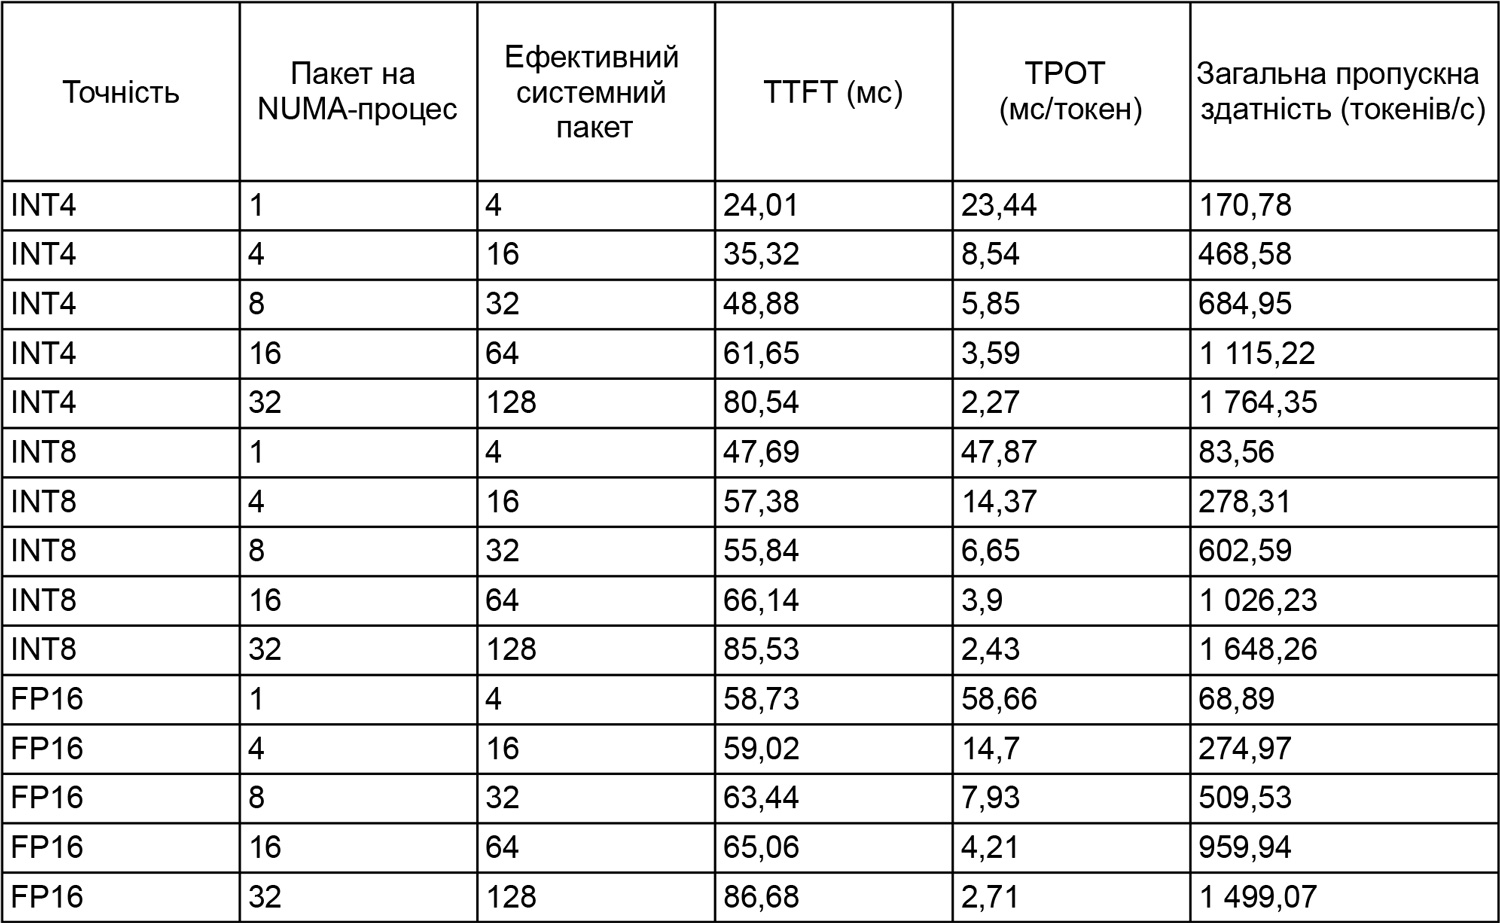
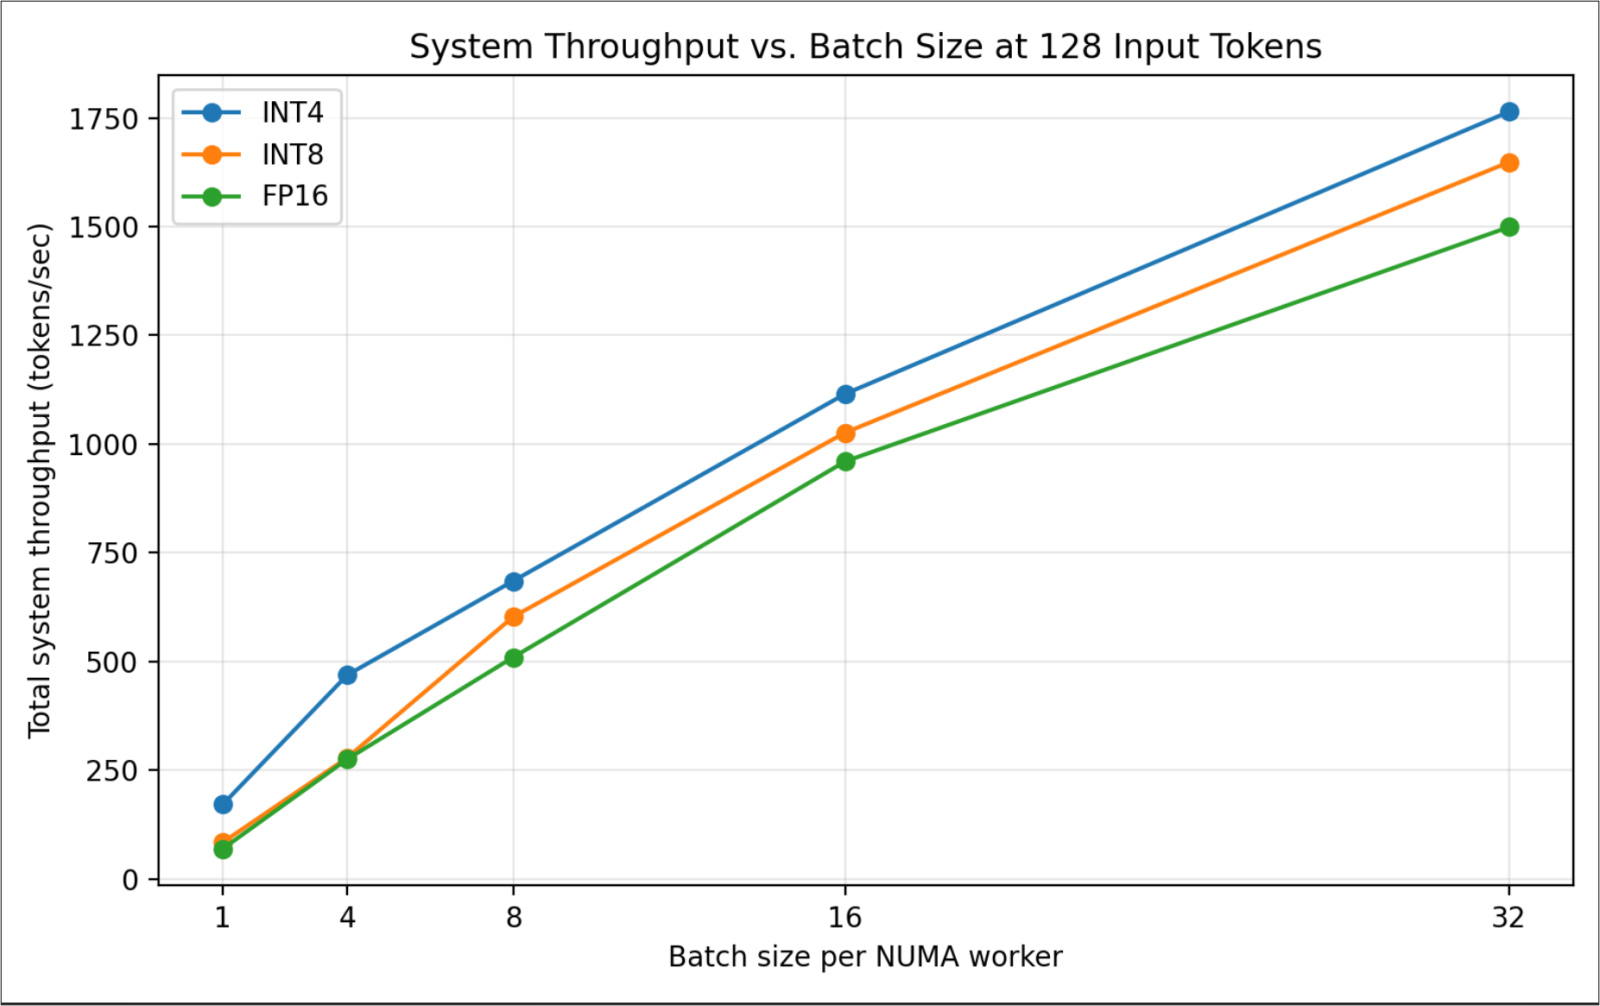
Рисунок 5. Загальна пропускна здатність системи залежно від розміру пакета при 128 вхідних токенах
Основний висновок полягає в тому, що розмір пакета слід обирати відповідно до сценарію розгортання:
-
1–4 на NUMA-процес найкраще підходить для інтерактивних сценаріїв або сценаріїв, чутливих до затримки.
-
8–16 на NUMA-процес забезпечує збалансований робочий діапазон для спільних сервісів малого та середнього бізнесу.
-
16–32 на NUMA-процес найкраще підходить для навантажень, орієнтованих на максимальну пропускну здатність, або завдань, що обробляються в черзі.
Більші пакети підвищують пропускну здатність системи та ефективність генерації токенів, але водночас збільшують затримку до початку відповіді.
Довжина вхідного токена
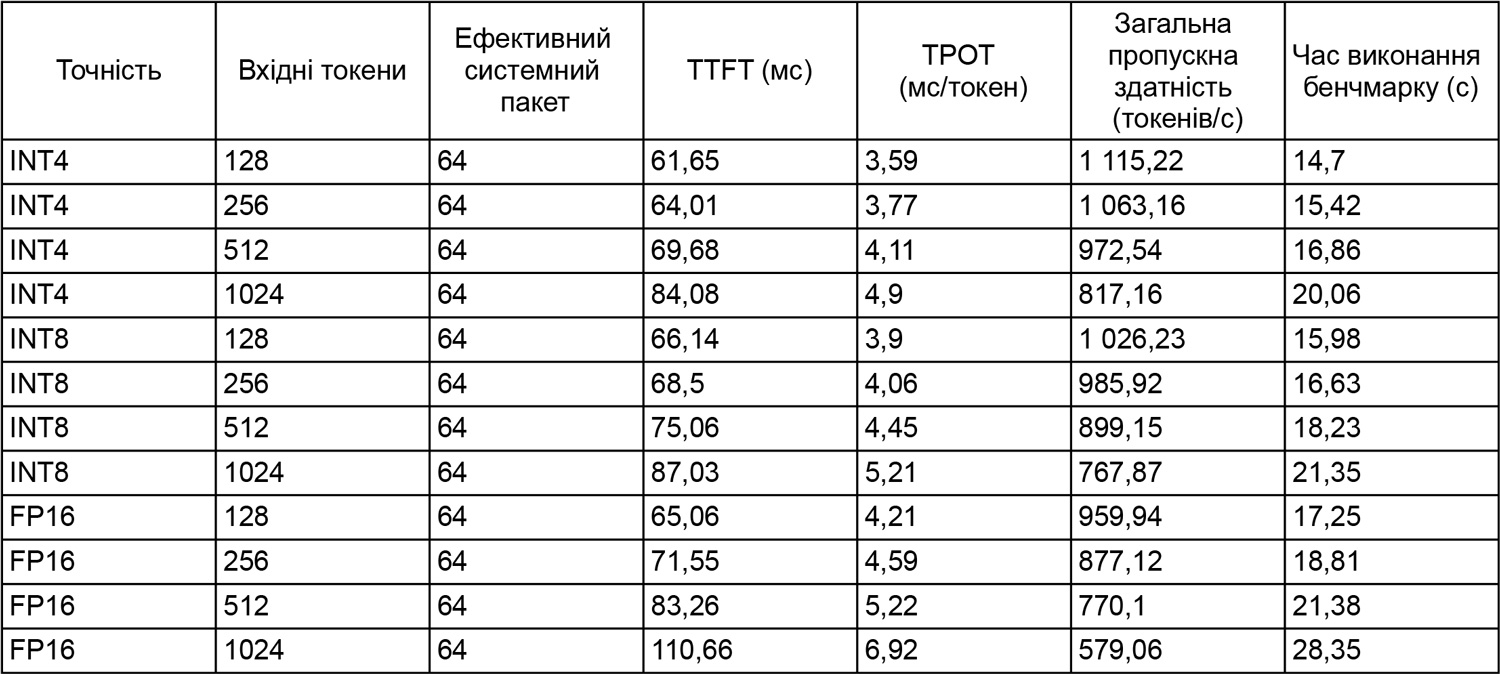
Довші промпти збільшують обсяг обчислень, необхідних для їх обробки. У результаті зростають TTFT і загальний час виконання бенчмарку, а загальна пропускна здатність системи знижується. Цей ефект був найбільш помітним за більших розмірів пакетів, коли чотири локально прив’язані до NUMA воркери одночасно обробляли більшу кількість токенів промпту.
У таблиці нижче показано вплив довжини вхідної послідовності за розміру пакета 16 на кожен NUMA-воркер. Цей розмір було обрано, оскільки він відповідає збалансованому режиму роботи спільного сервісу: достатньо великий, щоб продемонструвати поведінку системи під навантаженням, але не настільки орієнтований на максимальну пропускну здатність, як пакет 32.
Таблиця 7. Продуктивність за різної довжини вхідної послідовності при розмірі пакета 16 на NUMA-воркер
На рисунку нижче показано зміну загальної пропускної здатності системи зі збільшенням довжини вхідної послідовності зі 128 до 1024 токенів.
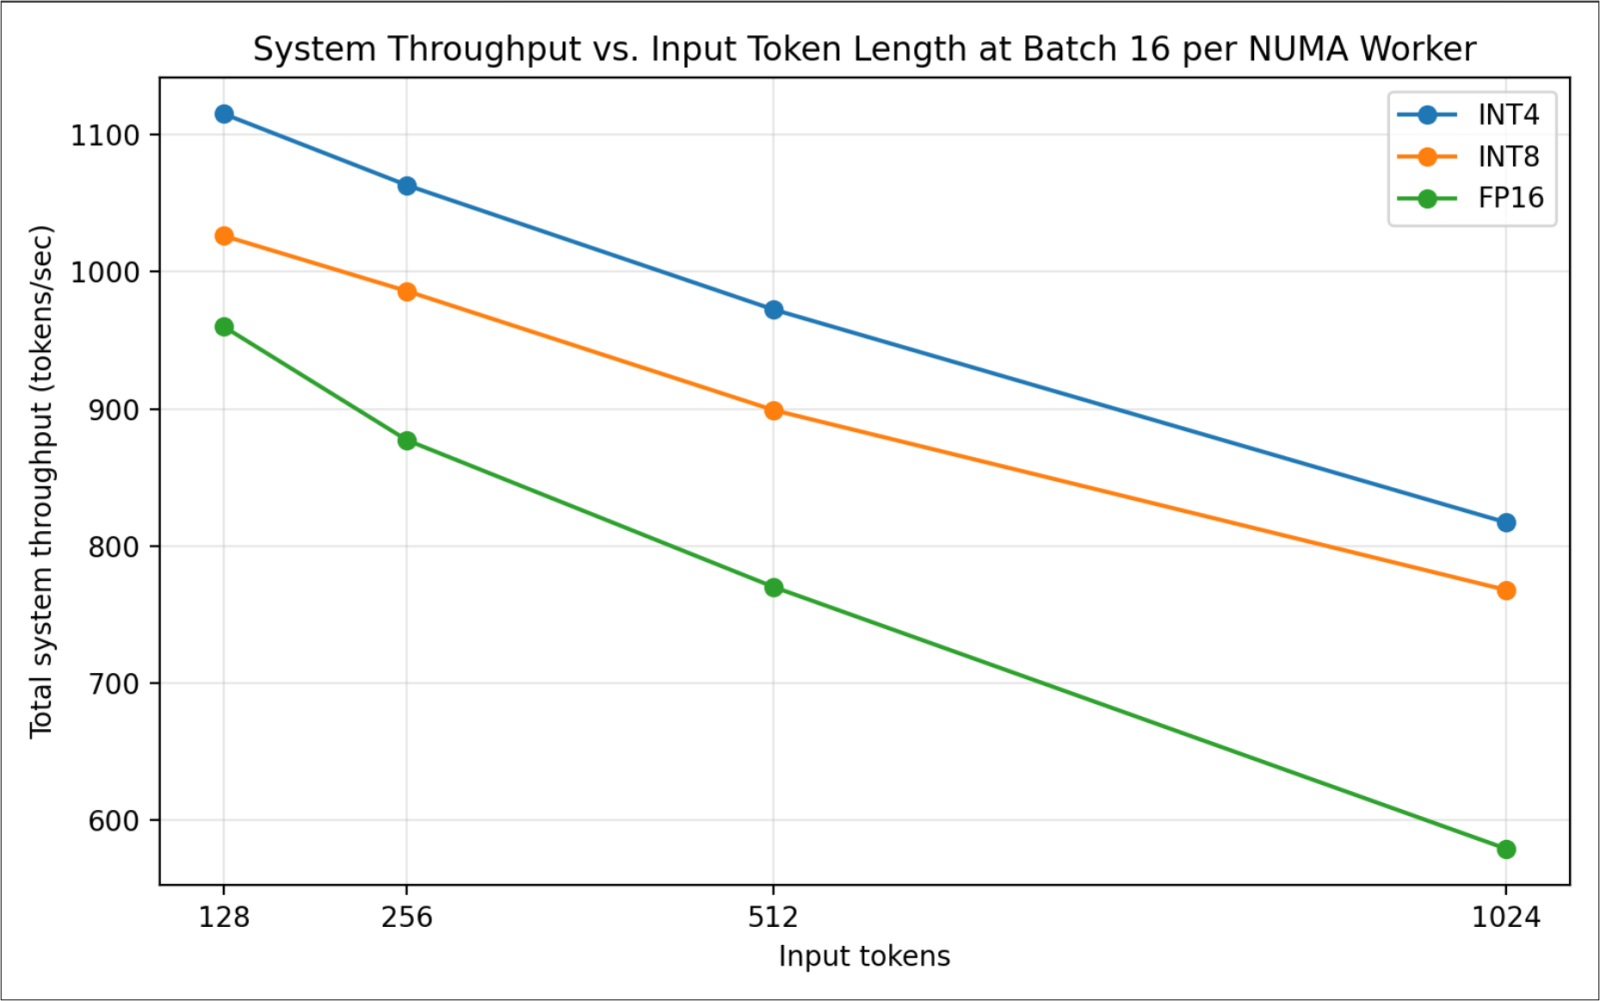
Рисунок 6. Пропускна здатність системи залежно від довжини вхідної послідовності при розмірі пакета 16 на NUMA-воркер
Зі збільшенням довжини вхідної послідовності загальна пропускна здатність системи знижується. INT4 зберігає найвищу пропускну здатність для всіх протестованих довжин, далі йдуть INT8 і FP16. Таке зниження є очікуваним, оскільки довші промпти потребують більшого обсягу обробки до початку та під час генерації.
Ключові висновки
Результати бенчмарку дають змогу зробити такі висновки:
-
Хоча квантування INT4 забезпечує до приблизно 2,5 раза вищу пропускну здатність порівняно з FP16 за малих розмірів пакетів (і приблизно в 1,3 раза вищу в середньому для всієї матриці робочих навантажень), перед розгортанням у продуктивному середовищі підприємствам слід окремо оцінювати точність для конкретних завдань. Загальнодоступні результати оцінювання свідчать, що сучасне 4-бітне квантування лише ваг моделі зазвичай дає змогу зберегти більшу частину точності в бенчмарках, однак ступінь її зниження залежить від методу та конкретного завдання.
-
INT8 і FP16 також забезпечили прийнятну затримку до початку відповіді для протестованих робочих навантажень. У повному наборі результатів системного бенчмарку середній TTFT залишався нижчим за 200 мс для всіх трьох форматів точності, що забезпечує достатню швидкість відгуку для багатьох інтерактивних сценаріїв використання SLM і спільних сервісів.
-
Більші розміри пакетів підвищували пропускну здатність і зменшували TPOT, але збільшували TTFT. Це підтверджує очікуваний компроміс між продуктивністю системи та затримкою до початку відповіді. Для більшості сценаріїв розгортання пакети розміром від 1 до 16 на NUMA-воркер забезпечують найбільш практичний баланс між швидкістю відгуку та пропускною здатністю системи.
-
Довші вхідні промпти знижували пропускну здатність і збільшували час виконання бенчмарку, особливо за більших розмірів пакетів. Це підтверджує, що довжину промпту необхідно враховувати під час визначення необхідних ресурсів системи.
Висновок
Результати перевірки інференсу малих мовних моделей (SLM) на системах Lenovo ThinkAgile HX V4 і FX V4 демонструють, що робочі навантаження генеративного ШІ можна ефективно виконувати на гіперконвергентній інфраструктурі на базі CPU без необхідності використовувати спеціалізовані GPU-платформи для кожного сценарію розгортання. Lenovo ThinkAgile HX V4 і FX V4 створюють готову до корпоративного використання основу для розгортання AI-інференсу на базі SLM поруч із бізнес-даними, застосунками та операційними робочими процесами. Це дає змогу ширше впроваджувати генеративний ШІ в різноманітних корпоративних сценаріях, водночас зберігаючи простоту, масштабованість та економічну ефективність.
Перелік компонентів: ThinkAgile HX650 V4
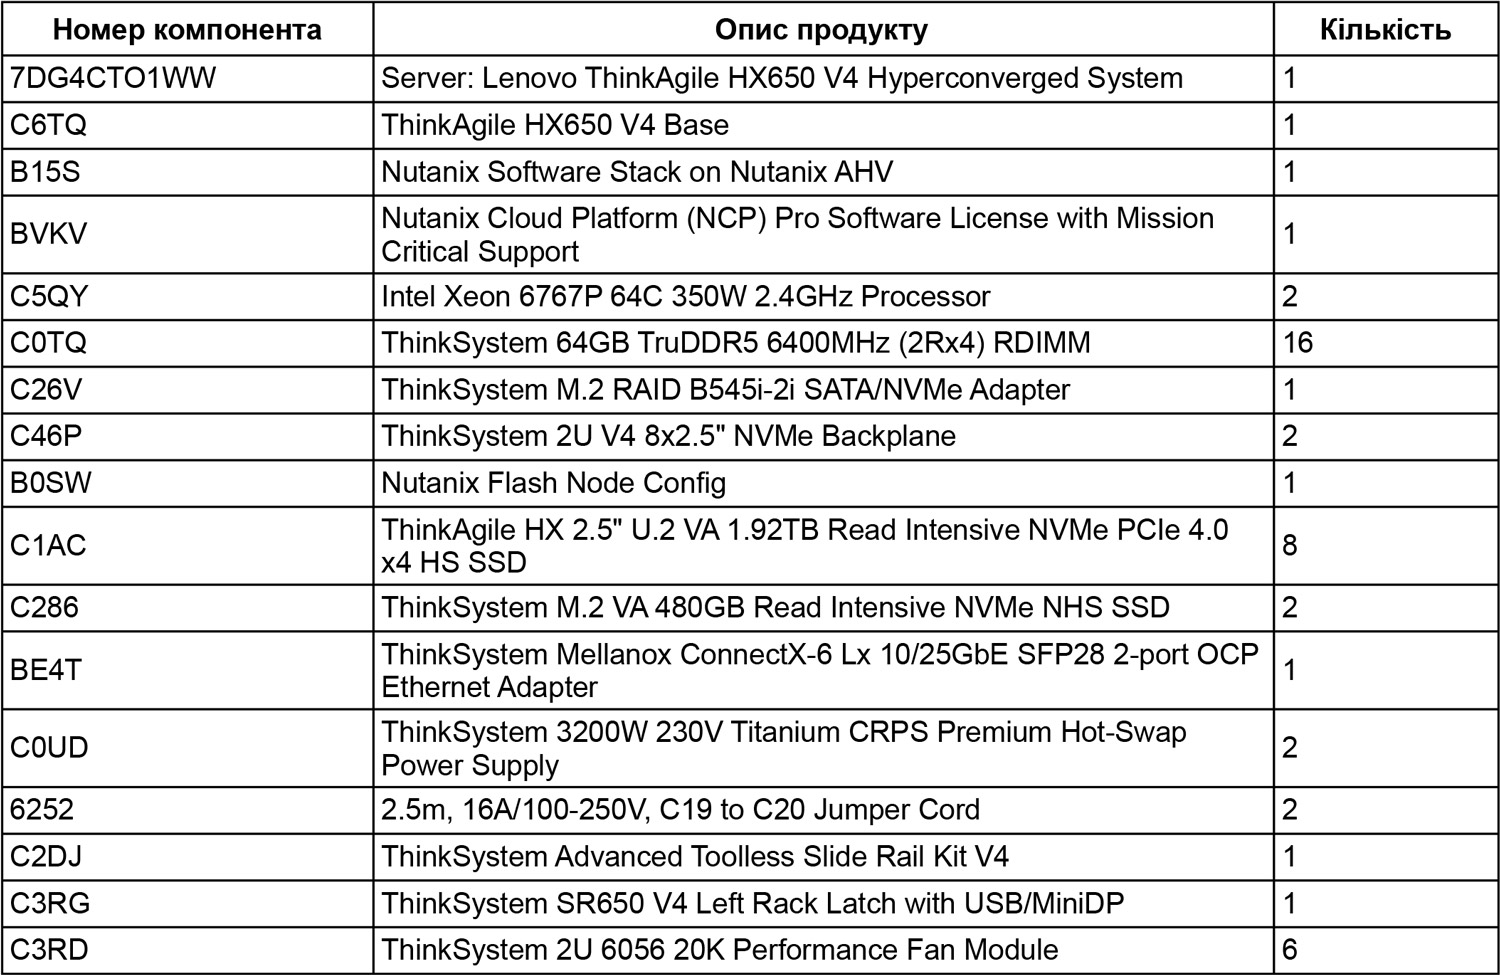
У таблиці нижче наведено перелік компонентів для одного вузла ThinkAgile HX650 V4 у конфігурації, перевіреній у цьому документі. Чотири вузли з ідентичною конфігурацією утворювали кластер Nutanix, описаний у таблиці 1.
Таблиця 8. Перелік компонентів: ThinkAgile HX650 V4
Ресурси
Докладнішу інформацію можна знайти в таких матеріалах:
-
Lenovo ThinkAgile HX650 V4 Hyperconverged System
https://lenovopress.lenovo.com/lp2133-lenovo-thinkagile-hx650-v4-hyperconverged-system -
Lenovo ThinkAgile HX630 V4 Hyperconverged System
https://lenovopress.lenovo.com/lp2132-lenovo-thinkagile-hx630-v4-hyperconverged-system -
Lenovo ThinkAgile FX650 V4 Hyperconverged System
https://lenovopress.lenovo.com/lp2338-lenovo-thinkagile-fx650-v4-hyperconverged-system -
Lenovo ThinkAgile FX630 V4 Hyperconverged System
https://lenovopress.lenovo.com/lp2337-lenovo-thinkagile-fx630-v4-hyperconverged-system -
OpenVINO GenAI Documentation — Performance Metrics
https://openvinotoolkit.github.io/openvino.genai/docs/guides/performance-metrics/ -
OpenVINO API Documentation — openvino_genai.PerfMetrics
https://docs.openvino.ai/2025/api/genai_api/_autosummary/openvino_genai.PerfMetrics.html -
OpenVINO API Documentation — openvino_genai.LLMPipeline
https://docs.openvino.ai/2025/api/genai_api/_autosummary/openvino_genai.LLMPipeline.html -
OpenVINO GenAI Documentation
https://openvinotoolkit.github.io/openvino.genai/ -
Microsoft Phi-3 Model Collection — Hugging Face
https://huggingface.co/collections/microsoft/phi-3 -
Microsoft Phi-3 Mini 128K Instruct — Hugging Face Model Card
https://huggingface.co/microsoft/Phi-3-mini-128k-instruct -
OpenVINO Phi-3 Mini 128K Instruct INT4 Model — Hugging Face
https://huggingface.co/OpenVINO/Phi-3-mini-128k-instruct-int4-ov -
Intel AI Development Software
https://www.intel.com/content/www/us/en/developer/topic-technology/artificial-intelligence/development-software.html
Автор
Cristian Ghetau – інженер-консультант Lenovo у Румунії, має досвід роботи з технологіями хмарної інфраструктури. Понад 13 років працює з віртуальними середовищами VMware, Microsoft, Oracle і Linux.
Пов’язані сімейства продуктів
З цим документом пов’язані такі сімейства продуктів:
Торговельні марки
Lenovo та логотип Lenovo є торговельними марками або зареєстрованими торговельними марками Lenovo у США, інших країнах або одночасно у США та інших країнах. Поточний список торгових марок Lenovo доступний в Інтернеті за адресою https://www.lenovo.com/us/en/legal/copytrade/
Наведені нижче назви є торговельними марками Lenovo у США, інших країнах або одночасно у США та інших країнах:
Lenovo®
ThinkAgile®
ThinkSystem®
Наведені нижче назви є торговельними марками інших компаній:
Intel®, логотип Intel, OpenVINO® та Xeon® є торговельними марками Intel Corporation або її дочірніх компаній.
Linux® є торговельною маркою Linus Torvalds у США та інших країнах.
Microsoft® є торговельною маркою Microsoft Corporation у США, інших країнах або одночасно у США та інших країнах.
Інші назви компаній, продуктів або сервісів можуть бути торговельними марками або знаками обслуговування відповідних власників.
© 2026 Lenovo. Усі права захищені.