Планирование / Внедрение
Аннотация
В этом документе представлены результаты тестирования производительности и рекомендации по развертыванию малых языковых моделей (Small Language Models, SLM) на серверах Lenovo ThinkAgile HX V4 и FX V4 с процессорами Intel Xeon 6 и программным обеспечением Nutanix без необходимости использования специализированных GPU-платформ. Для тестирования использовалась модель Microsoft Phi-3 Mini 128K Instruct, оптимизированная с помощью Intel OpenVINO. Документ охватывает форматы точности INT4, INT8 и FP16, а полученные результаты используются для формирования рекомендаций по определению необходимых ресурсов и схем развертывания для интерактивных, потоковых и совместных сервисов, а также рабочих нагрузок, ориентированных на максимальную пропускную способность.
Документ предназначен для ИТ-архитекторов, инженеров по инфраструктуре и технических специалистов, которые принимают решения и оценивают возможности локального развертывания генеративного ИИ. Предполагается, что читатели имеют практические знания гиперконвергентной инфраструктуры, виртуализации серверов и основных принципов инференса больших языковых моделей (LLM).
Введение
Использование генеративного ИИ стремительно распространяется среди крупных предприятий и компаний малого и среднего бизнеса, которые ищут практические способы повысить продуктивность, автоматизировать рабочие процессы, связанные с обработкой знаний, создавать краткие бизнес-резюме и развертывать ИИ-ассистентов рядом с корпоративными данными. Малые языковые модели (SLM) позволяют реализовать эти возможности на современной инфраструктуре на базе CPU, снижая зависимость от специализированных GPU-платформ и при этом сохраняя более простую и экономически эффективную операционную модель.
Этот технический документ определяет проверенные архитектурные подходы и основу для развертывания малых языковых моделей (SLM) на CPU-инфраструктуре на базе серверов Lenovo ThinkAgile HX V4 и FX V4 с программным обеспечением Nutanix и процессорами Intel Xeon 6. Результаты тестирования положены в основу масштабируемых схем развертывания и практических рекомендаций по определению необходимых ресурсов, которые помогают малым и средним предприятиям (SME) находить оптимальный баланс между задержкой и пропускной способностью для корпоративных сценариев использования.
В протестированной архитектуре развертывание малых языковых моделей (SLM) оптимизировано благодаря квантованным форматам смешанной точности (INT4/INT8), выполняемым локально в изолированной среде виртуальной машины с привязкой к NUMA.
Для предприятий, рассматривающих распределённое многовузловое масштабирование несжатых весов модели с использованием нативных актуальных фреймворков, доступен дополнительный технический документ: Оптимизация распределённого инференса SLM на серверах Lenovo ThinkAgile VX V4 и FX V4 с использованием VMware Cloud Foundation 9.0
Lenovo ThinkAgile HX V4 и FX V4 с процессорами Intel Xeon 6
Lenovo ThinkAgile HX650 V4 и FX650 V4 – это двухсокетные системы форм-фактора 2U, а Lenovo ThinkAgile HX630 V4 и FX630 V4 – двухсокетные системы форм-фактора 1U. Эти гиперконвергентные системы оснащаются двухсокетными процессорами Intel Xeon 6 (ранее известными под кодовым названием Granite Rapids). Гиперконвергентные системы ThinkAgile HX V4 и FX V4 предназначены для развертывания ведущего программного обеспечения Nutanix для гиперконвергентной инфраструктуры на корпоративных платформах Lenovo.
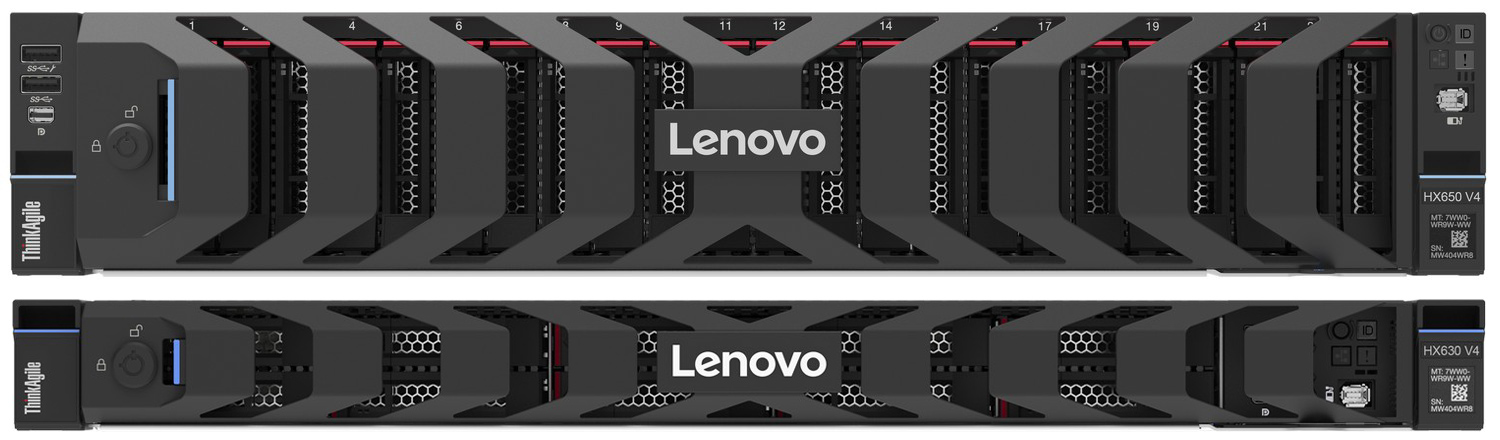
Рисунок 1. ThinkAgile HX650 V4 (вверху) и HX630 V4 (внизу), разработанные для гиперконвергентной инфраструктуры Nutanix
Nutanix Cloud Platform (NCP) обеспечивает преимущества облачного масштаба для корпоративных приложений и баз данных, объединяя ThinkAgile HX V4 и FX V4 с инфраструктурой публичного облака. Платформа предлагает надёжное корпоративное хранение данных, интегрированную защиту данных, встроенную отказоустойчивость, унифицированное управление, расширенную аналитику, комплексную сквозную защиту и стабильную производительность для критически важных рабочих нагрузок.
ThinkAgile FX предлагает уникальную для отрасли гибкость программно-определяемого подхода к гиперконвергенции. Возможность переходить между выбранными гипервизорами позволяет объединять вычислительные ресурсы, хранение данных и управление в тесно интегрированном программном стеке, а также защищать инвестиции в долгосрочной перспективе благодаря беспрепятственному переходу между программными решениями HCI.
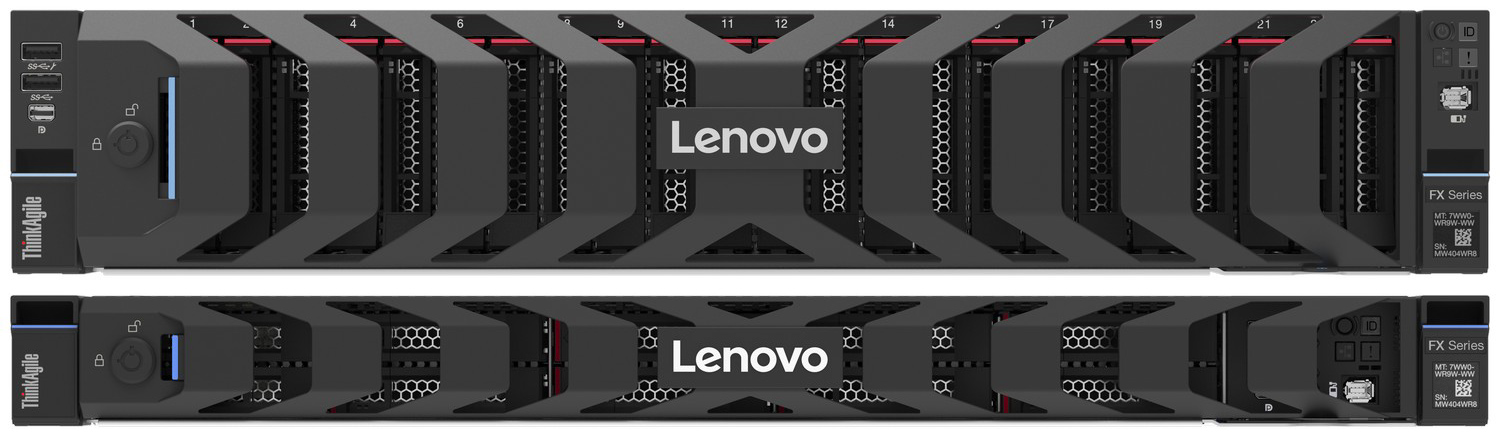
Рисунок 2. ThinkAgile FX650 V4 (вверху) и FX630 V4 (внизу), разработанные для гибкой гиперконвергентной инфраструктуры
Конфигурация оборудования
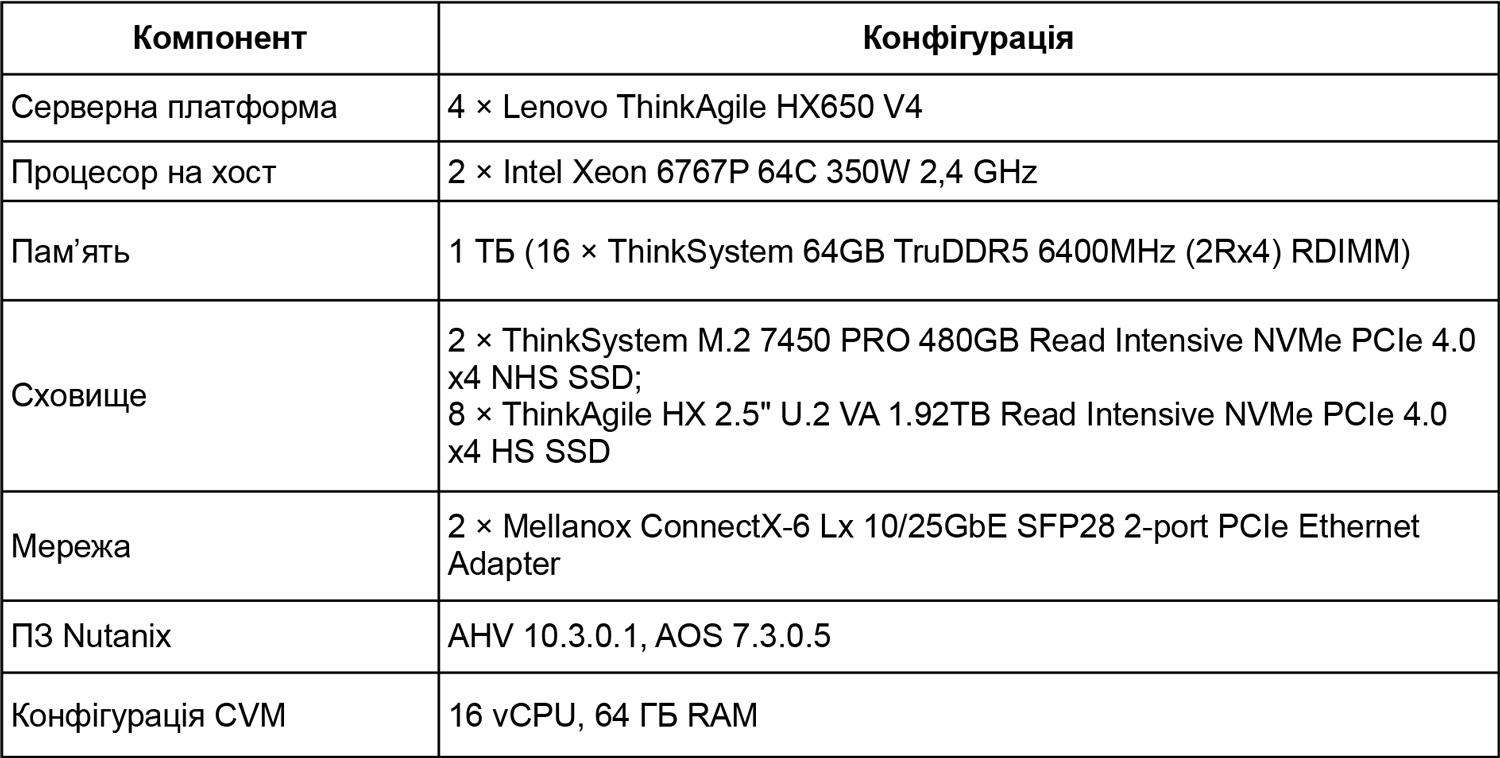
Аппаратная конфигурация отражает типичный сценарий развертывания для малого и среднего бизнеса, в котором инференс генеративного ИИ может выполняться на системах Lenovo ThinkAgile HX/FX V4 с Nutanix и процессорами Intel Xeon 6.
Таблица 1. Конфигурация кластера Lenovo ThinkAgile HX650 V4
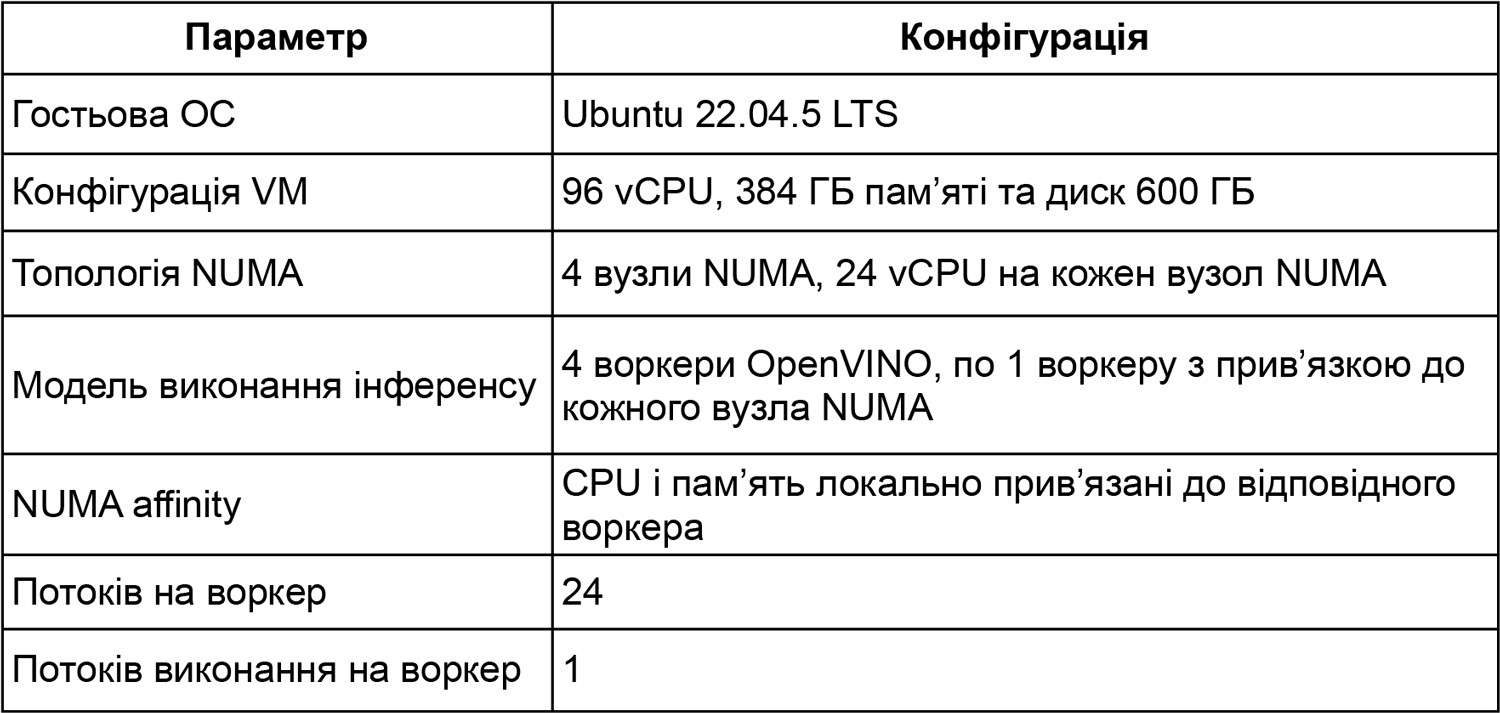
Ниже приведена конфигурация виртуальной машины.
Таблица 2. Конфигурация виртуальной машины
Конфигурация программного обеспечения
Стек инференса базировался на OpenVINO GenAI, который предоставляет оптимизированные конвейеры генеративного ИИ для выполнения инференса на CPU на аппаратном обеспечении Intel.
Таблица 3. Конфигурация программного обеспечения
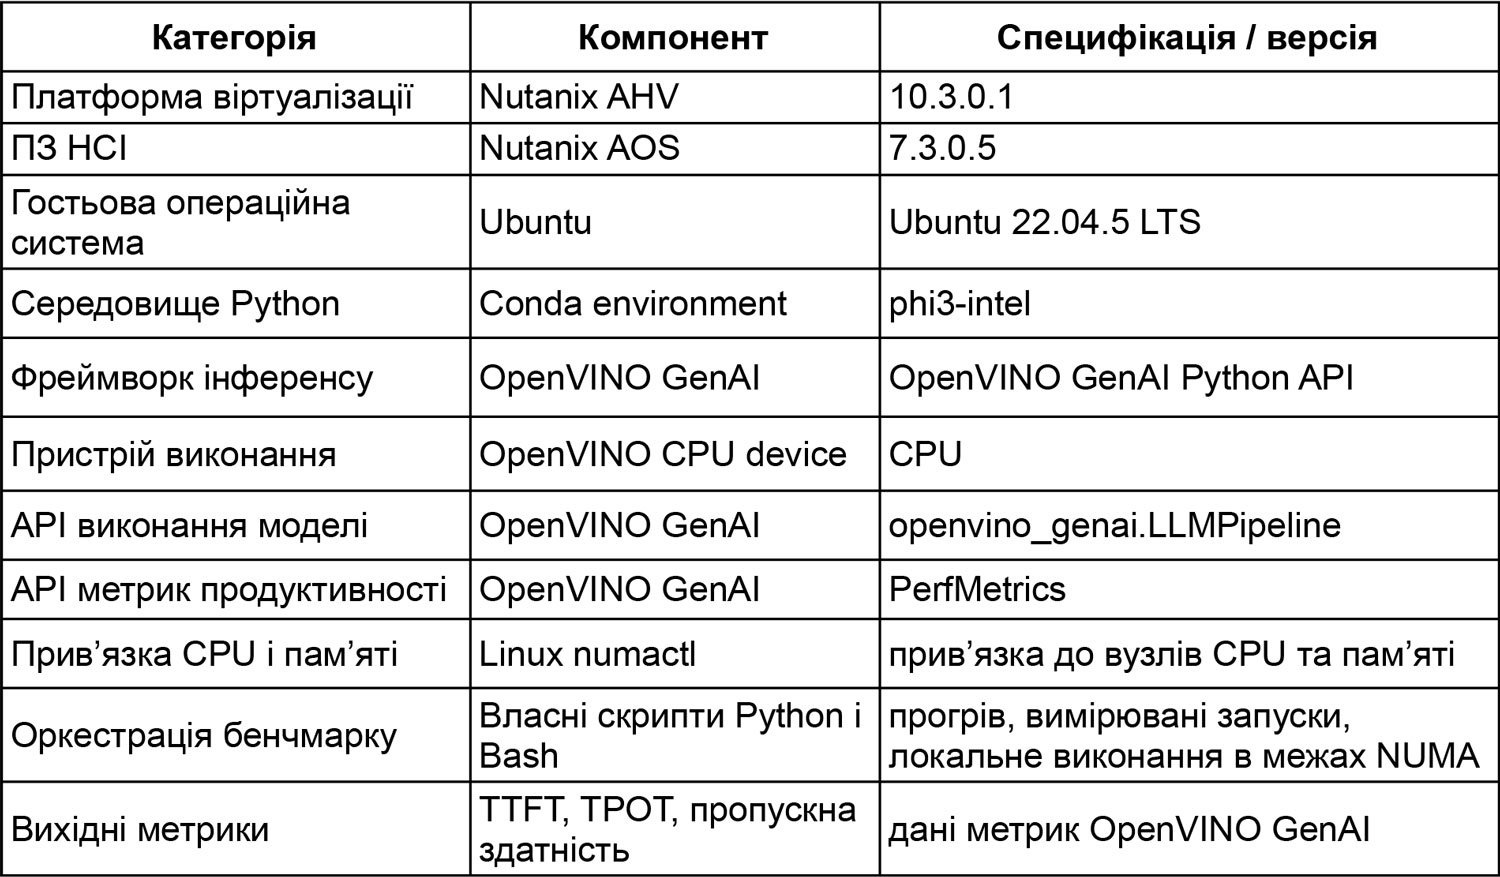
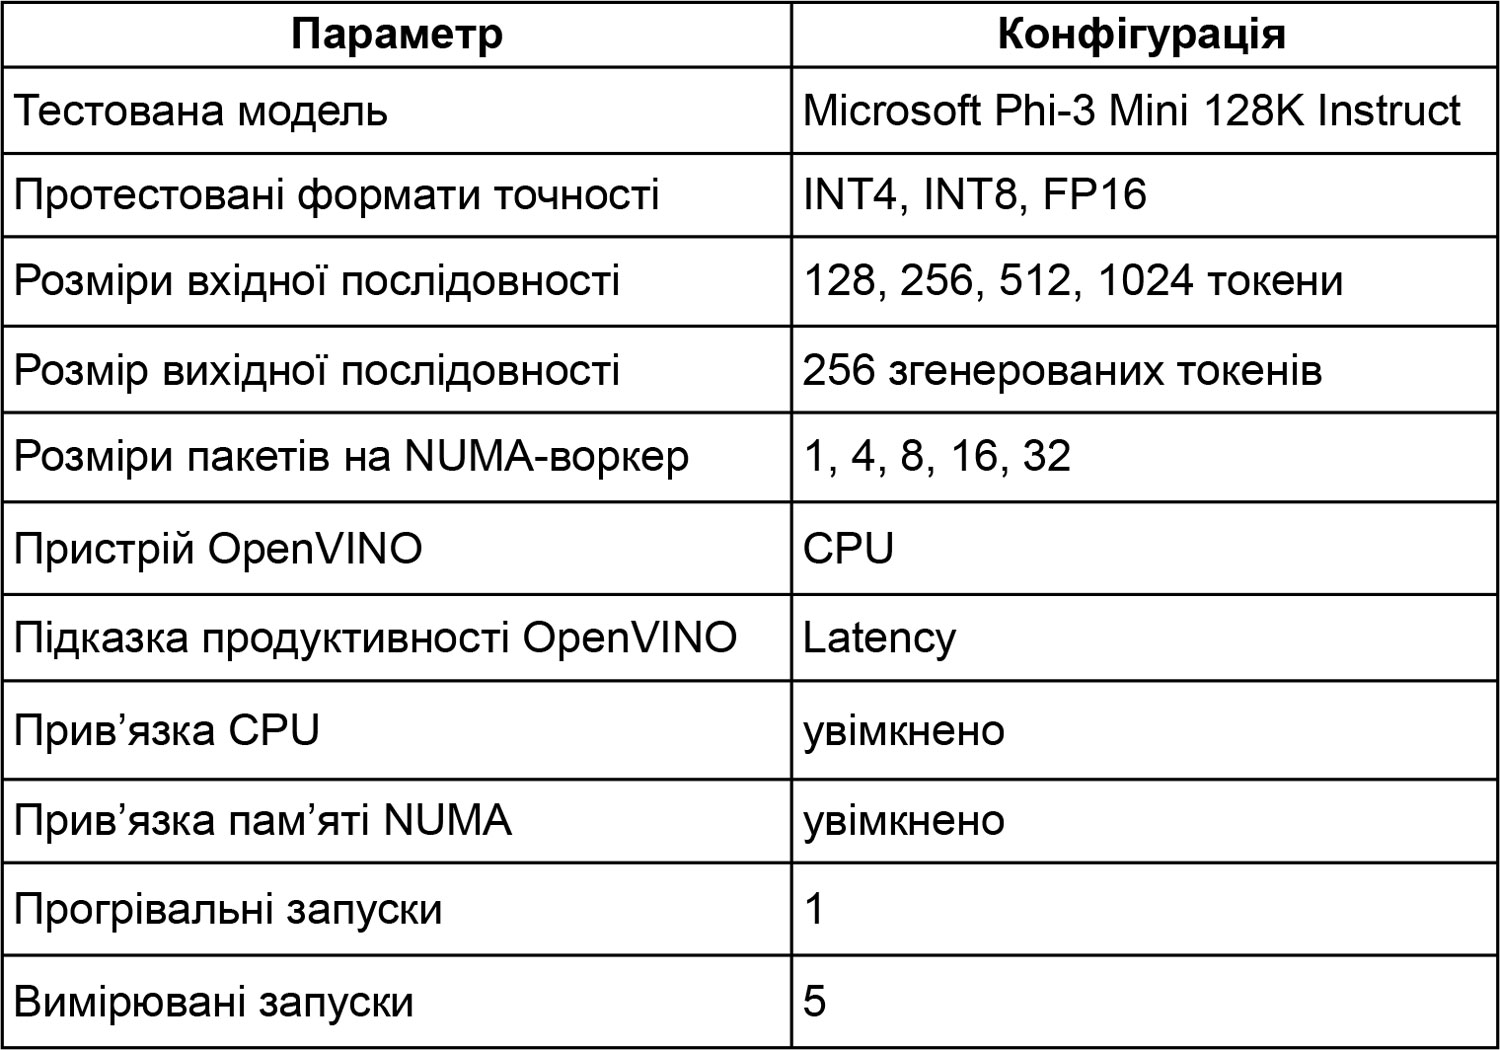
Таблица 4. Конфигурация модели и среды выполнения
Методология тестирования
Для этой проверки использовался фреймворк инференса OpenVINO GenAI, который предоставляет оптимизированные конвейеры генеративного ИИ поверх OpenVINO Runtime. OpenVINO GenAI предоставляет API LLMPipeline для запуска языковых моделей на таких устройствах, как CPU, а также встроенные метрики производительности через PerfMetrics (openvinotoolkit.github.io). Для тестирования была выбрана Microsoft Phi-3 Mini 128K Instruct – малая языковая модель из семейства Microsoft Phi-3 (huggingface.co), подходящая для таких сценариев, как работа с корпоративными знаниями, создание кратких резюме, взаимодействие с документами и автоматизация рабочих процессов.
В результатах общая пропускная способность суммируется для четырёх воркеров, поскольку каждый из них генерирует токены независимо. Значения TTFT и TPOT не суммируются: они рассматриваются как показатели скорости отклика отдельного воркера при параллельном выполнении. Такой подход позволяет отделить общую производительность системы от характеристик задержки отдельного запроса.
Конфигурация бенчмарка
Для каждой тестовой точки запускались четыре независимых воркера OpenVINO GenAI, по одному на каждый узел NUMA. Каждый воркер использовал 24 потока инференса, один поток выполнения, один прогревочный запуск и пять измеряемых запусков.
Прогревочный запуск использовался для уменьшения влияния холодного старта перед сбором результатов измерений. Приведённые значения являются средними за пять измеряемых запусков после одного прогревочного запуска.
Во время бенчмарка собирались следующие метрики OpenVINO GenAI PerfMetrics:
-
TTFT (Time to First Token, время до получения первого токена) показывает, насколько быстро генерируется первый токен; ключевой показатель скорости отклика в интерактивных сценариях, то есть задержки до начала ответа. Метрика получается через PerfMetrics API OpenVINO GenAI для одного пакетного вызова generate(). Эмпирическая проверка подтвердила, что этап prefill выполняется параллельно для всего пакета: фактическое время до завершения генерации первого токена для всех последовательностей соответствует приведённому среднему TTFT с отклонением в пределах 1% для Batch 32, наибольшей протестированной конфигурации. Это подтверждает, что TTFT отражает фактическую задержку до первого токена для отдельного запроса.
TPOT (Time per Output Token, время на один выходной токен) характеризует стабильную скорость генерации после первого токена, то есть скорость потоковой генерации. Показатель отражает совокупную эффективность пропускной способности воркера в параллельном конвейере обработки. Задержка потоковой генерации для отдельного пользовательского запроса внутри пакета рассчитывается как Batch Size × System TPOT.
- Throughput (пропускная способность) – количество сгенерированных токенов в секунду.
- Generate duration (продолжительность генерации) – время генерации моделью фиксированного ответа объёмом 256 токенов.
Целью было измерить максимальную пропускную способность и определить, как точность модели, размер пакета, длина входной последовательности и локальное выполнение в пределах NUMA влияют на скорость отклика и общую производительность системы.
Результаты анализируются с учётом следующих архитектурных сценариев развертывания ИИ-моделей:
-
Интерактивные сценарии (двусторонний разговор с пользователем в реальном времени) – сверхнизкий TTFT и предсказуемое время выполнения бенчмарка.
-
Потоковые сценарии (непрерывный односторонний ввод или вывод данных) – низкий TPOT и стабильная генерация.
-
Совместные сервисы (максимальное использование инфраструктуры и снижение затрат) – баланс между задержкой и совокупной пропускной способностью.
-
Нагрузки, ориентированные на пропускную способность – максимальный объём обработки, максимальная пропускная способность системы и эффективность пакетной обработки.
Результаты тестирования и анализ
В рамках всей матрицы рабочих нагрузок INT4 продемонстрировал наивысшую общую производительность инференса Phi-3 на CPU по показателям Time to First Token (TTFT), Time per Output Token (TPOT) и общей пропускной способности системы.
Основной компромисс заключается в том, что увеличение размера пакета повышает совокупную пропускную способность и улучшает TPOT, но одновременно увеличивает TTFT и общее время до завершения формирования ответа.
Пропускная способность
В приведённой ниже таблице показано, что для тестового сценария, наиболее чувствительного к задержке, INT4 обеспечил самый быстрый старт ответа, наивысшую скорость стабильной генерации токенов и наибольшую общую пропускную способность. INT4 продемонстрировал лучший баланс между скоростью отклика, стабильной скоростью генерации и общей пропускной способностью системы. INT8 оставался пригодной альтернативой со сжатием, однако в этом бенчмарке не превзошёл INT4. FP16 показал самую низкую пропускную способность и самую медленную стабильную генерацию для данной рабочей нагрузки, поэтому этот формат целесообразнее рассматривать как эталонную конфигурацию с более высокой точностью, а не как стандартный вариант для максимальной производительности.
В таблице приведены средние арифметические значения для всех протестированных размеров пакетов и длин входных последовательностей, чтобы показать общие закономерности масштабирования пропускной способности для форматов FP16, INT8 и INT4. Эти показатели не отражают профиль какого-либо одного рабочего пакета.
Таблица 5. Сводные показатели форматов точности для полной матрицы выполнения (сравнение форматов)
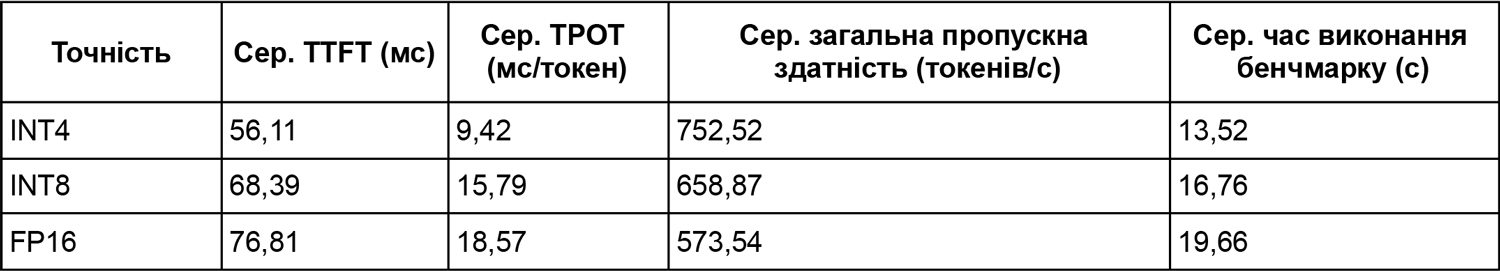
Следующие два графика показывают, что INT4 обеспечил самый низкий средний TTFT и наивысшую пропускную способность в пределах всей матрицы рабочих нагрузок, что свидетельствует о наименьшей задержке до начала ответа.
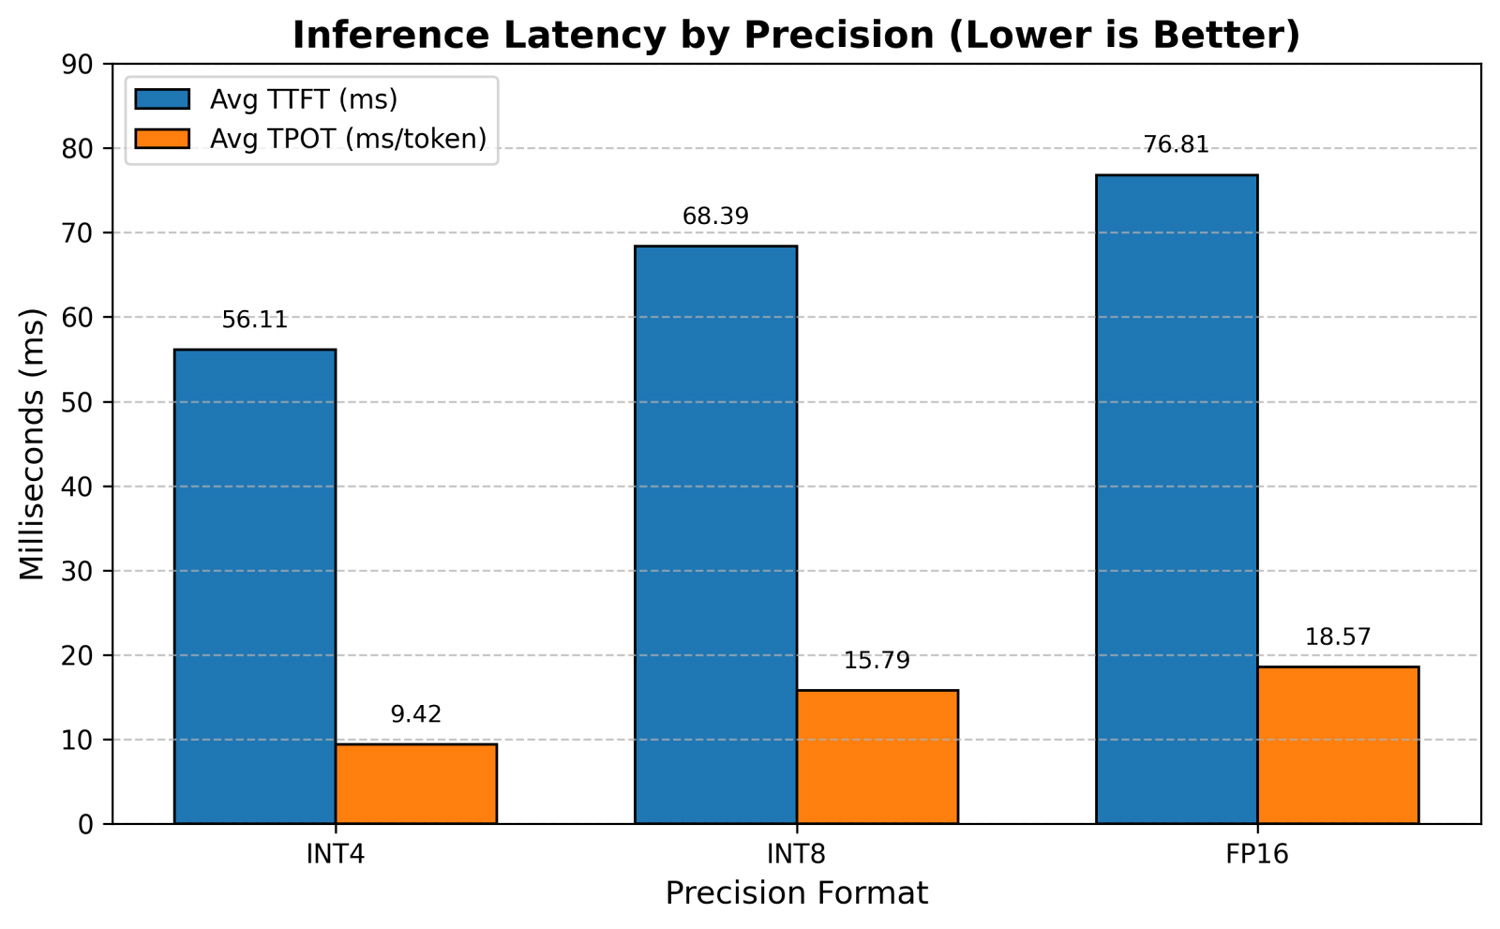
Рисунок 3. Задержка инференса в зависимости от формата точности (меньшее значение — лучше)
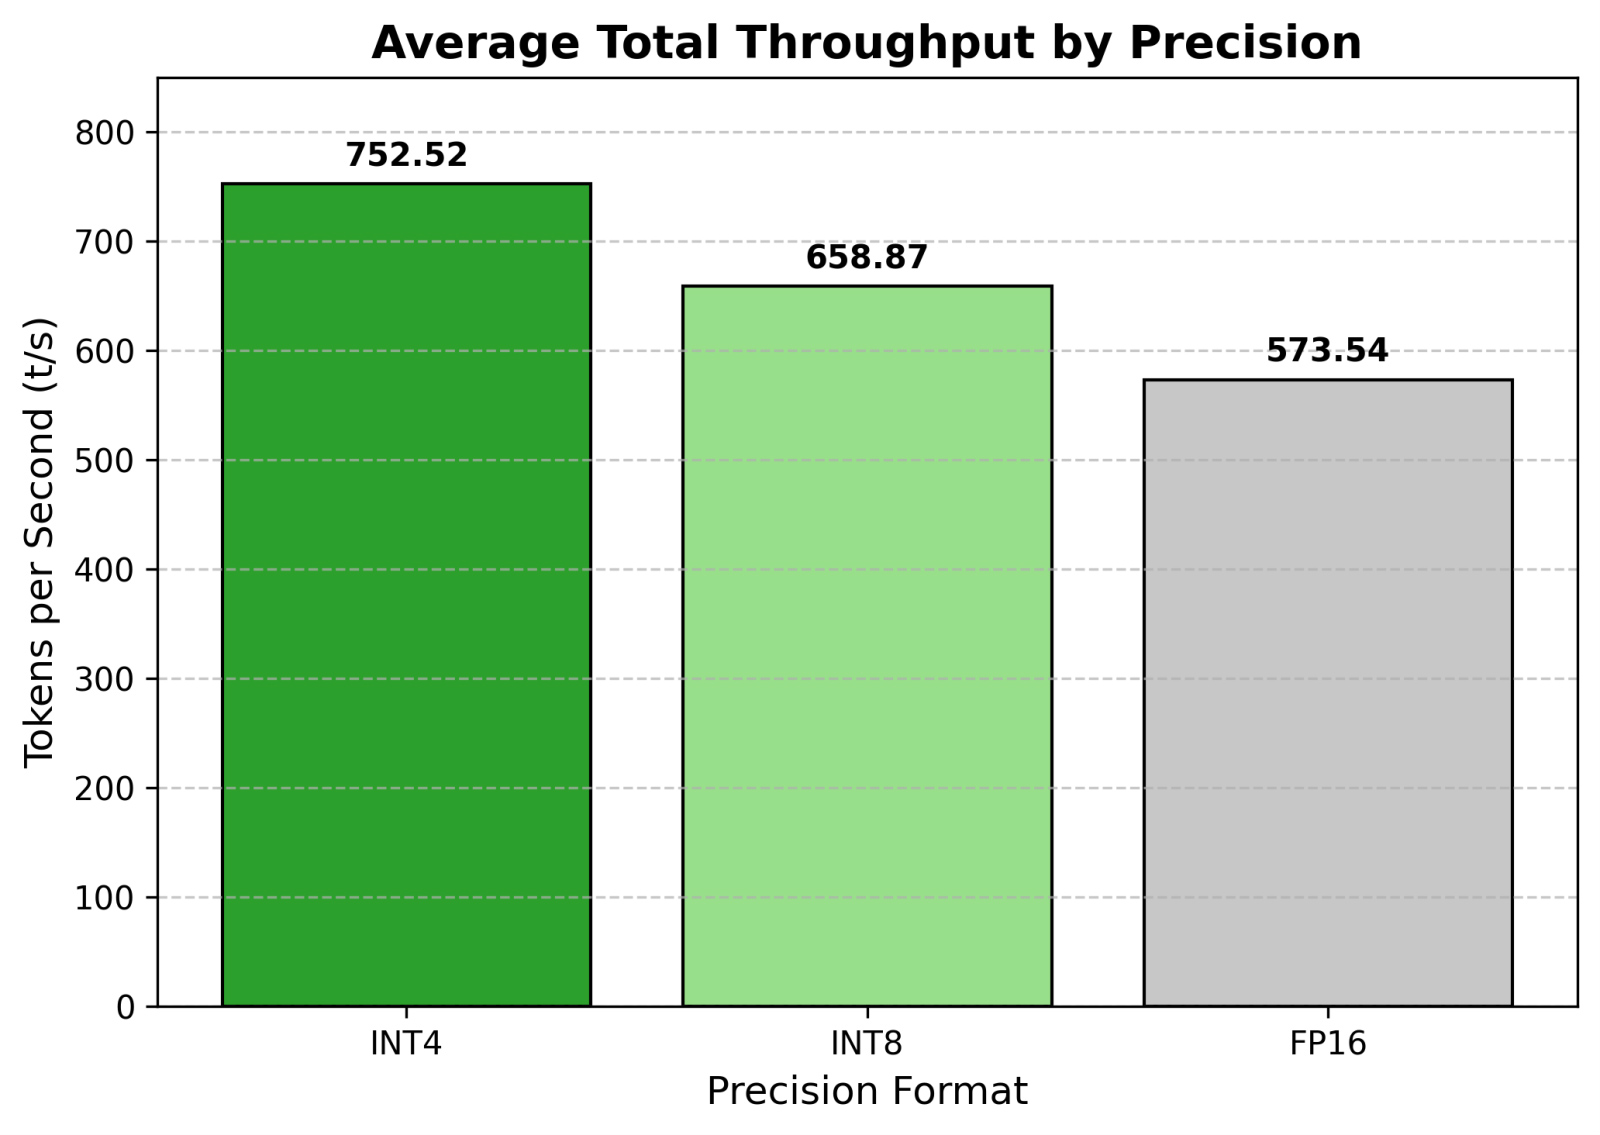
Рисунок 4. Средняя общая пропускная способность в зависимости от формата точности
Размер пакета
Увеличение размера пакета влияет как на общую пропускную способность системы, так и на задержку во всех протестированных форматах точности. С ростом размера пакета общая пропускная способность резко возрастала, а TPOT уменьшался, что свидетельствует о повышении эффективности стабильной генерации токенов. В то же время TTFT увеличивался: большие пакеты повышали пропускную способность системы, но увеличивали задержку до начала ответа.
Приведённые ниже таблица и график демонстрируют, что с увеличением размера пакета TTFT растёт, то есть конфигурации с более высокой пропускной способностью имеют большую задержку до начала ответа. INT4 сохраняет самый низкий TTFT во всём протестированном диапазоне размеров пакетов, тогда как INT8 и FP16 показывают более высокую задержку. TPOT при увеличении размера пакета уменьшается, что свидетельствует о повышении эффективности стабильной генерации токенов при более высоком уровне параллельного выполнения. INT4 сохраняет самый низкий TPOT во всём протестированном диапазоне, далее следуют INT8 и FP16.
Таблица 6. Производительность при различных размерах пакета при 128 входных токенах
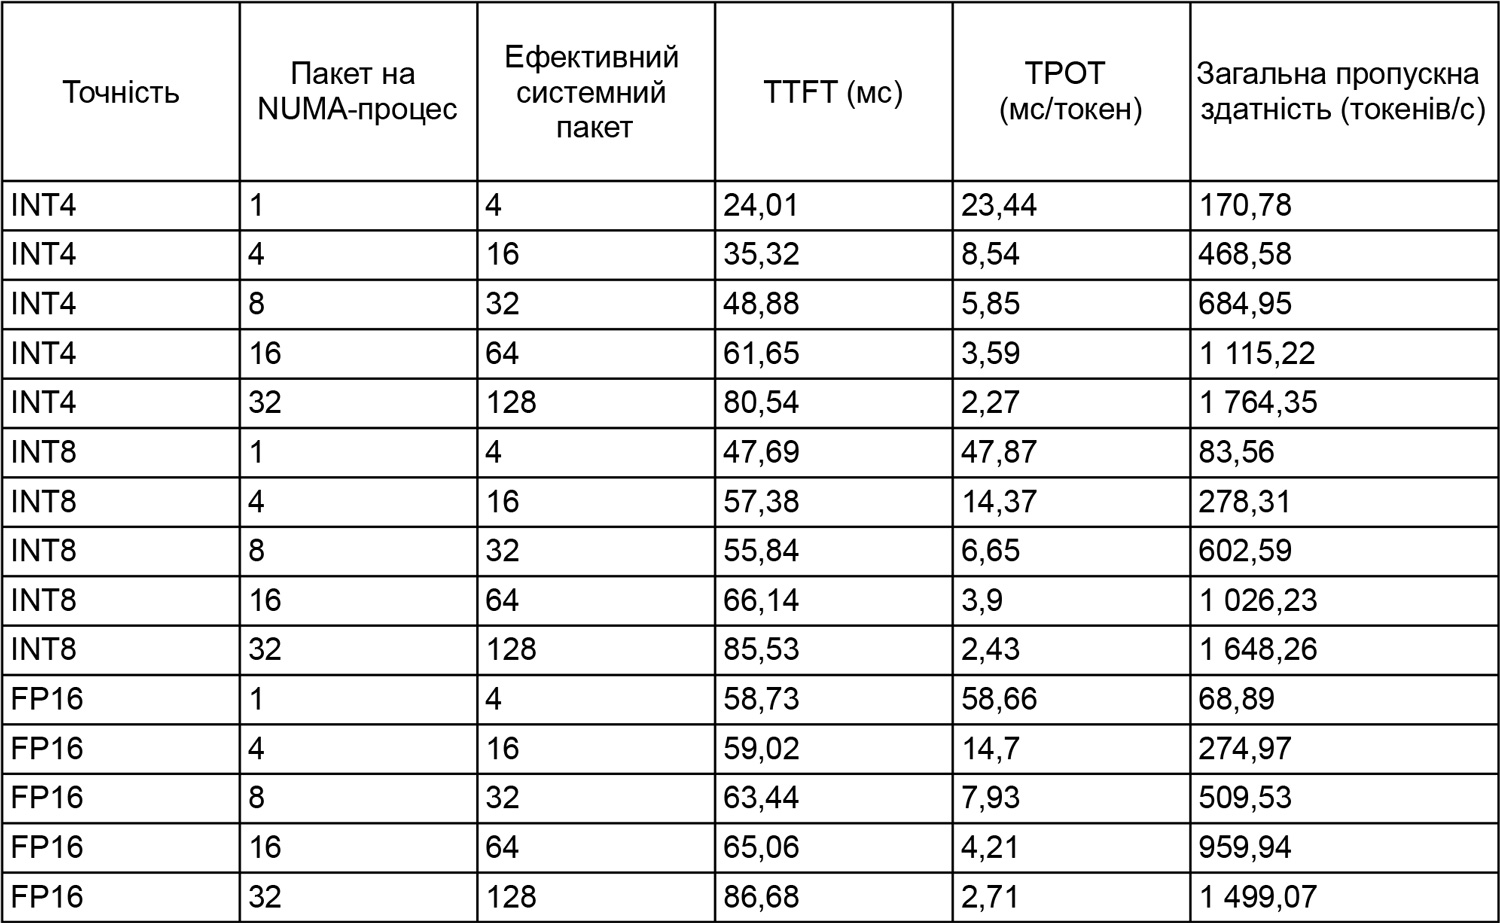
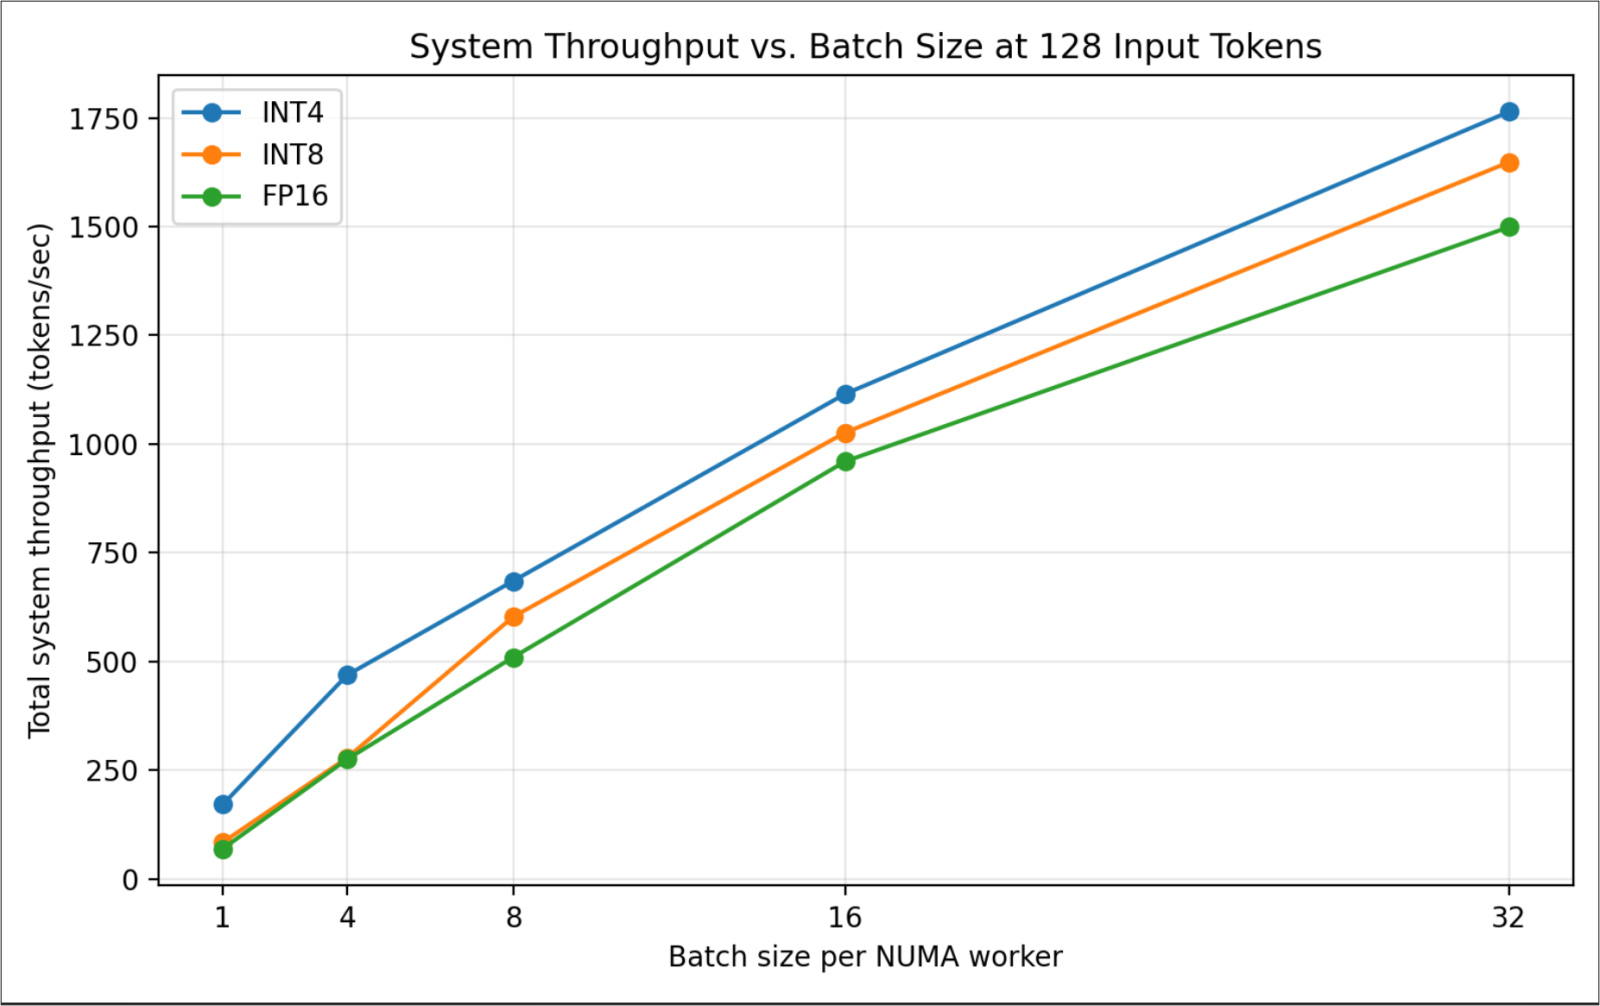
Рисунок 5. Общая пропускная способность системы в зависимости от размера пакета при 128 входных токенах
Основной вывод заключается в том, что размер пакета следует выбирать в соответствии со сценарием развертывания:
-
1–4 на NUMA-процесс лучше всего подходят для интерактивных сценариев или сценариев, чувствительных к задержке.
-
8–16 на NUMA-процесс обеспечивают сбалансированный рабочий диапазон для совместных сервисов малого и среднего бизнеса.
-
16–32 на NUMA-процесс лучше всего подходят для нагрузок, ориентированных на максимальную пропускную способность, или задач, обрабатываемых в очереди.
Большие пакеты повышают пропускную способность системы и эффективность генерации токенов, но одновременно увеличивают задержку до начала ответа.
Длина входного токена
Более длинные промпты увеличивают объём вычислений, необходимых для их обработки. В результате растут TTFT и общее время выполнения бенчмарка, а общая пропускная способность системы снижается. Этот эффект был наиболее заметен при больших размерах пакетов, когда четыре локально привязанных к NUMA воркера одновременно обрабатывали большее количество токенов промпта.
В таблице ниже показано влияние длины входной последовательности при размере пакета 16 на каждого NUMA-воркера. Этот размер был выбран, поскольку он соответствует сбалансированному режиму работы совместного сервиса: достаточно большой, чтобы продемонстрировать поведение системы под нагрузкой, но не настолько ориентированный на максимальную пропускную способность, как пакет 32.
Таблица 7. Производительность при различной длине входной последовательности при размере пакета 16 на NUMA-воркер
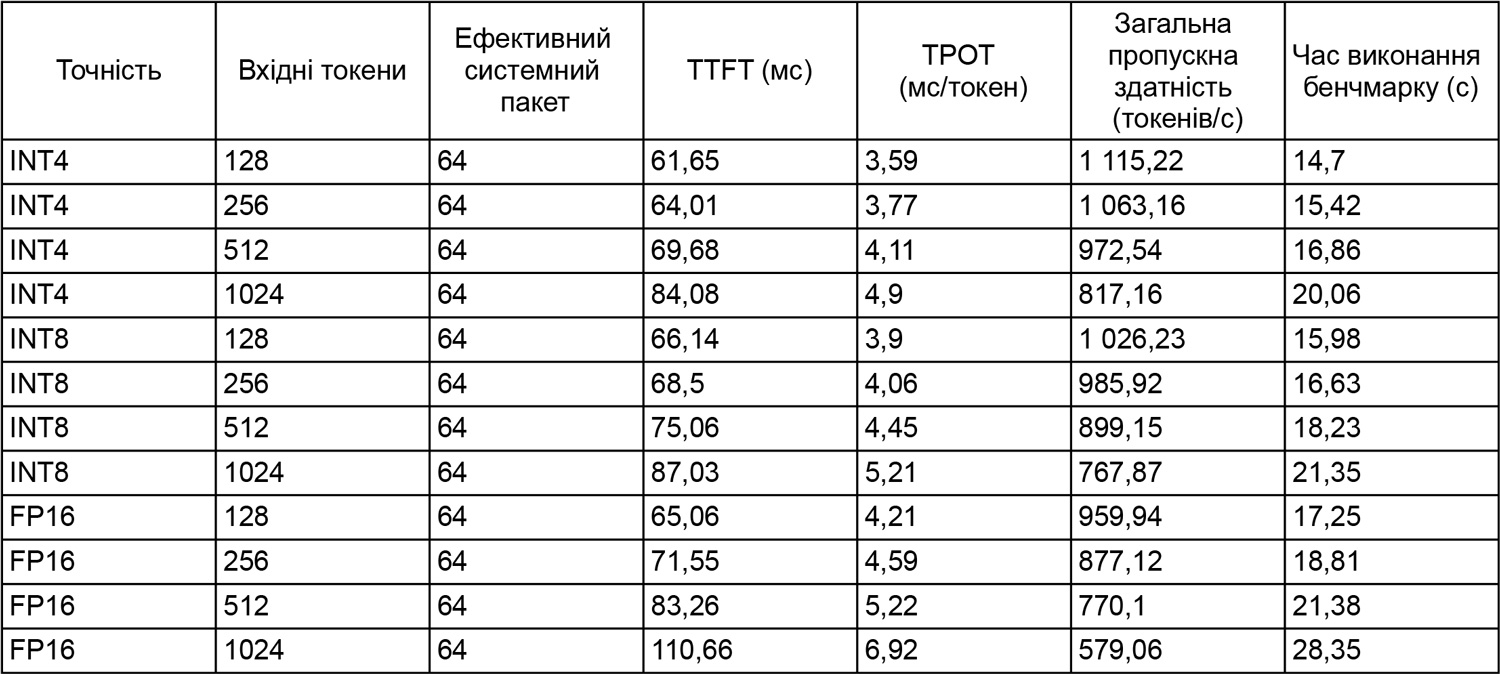
На рисунке ниже показано изменение общей пропускной способности системы при увеличении длины входной последовательности от 128 до 1024 токенов.
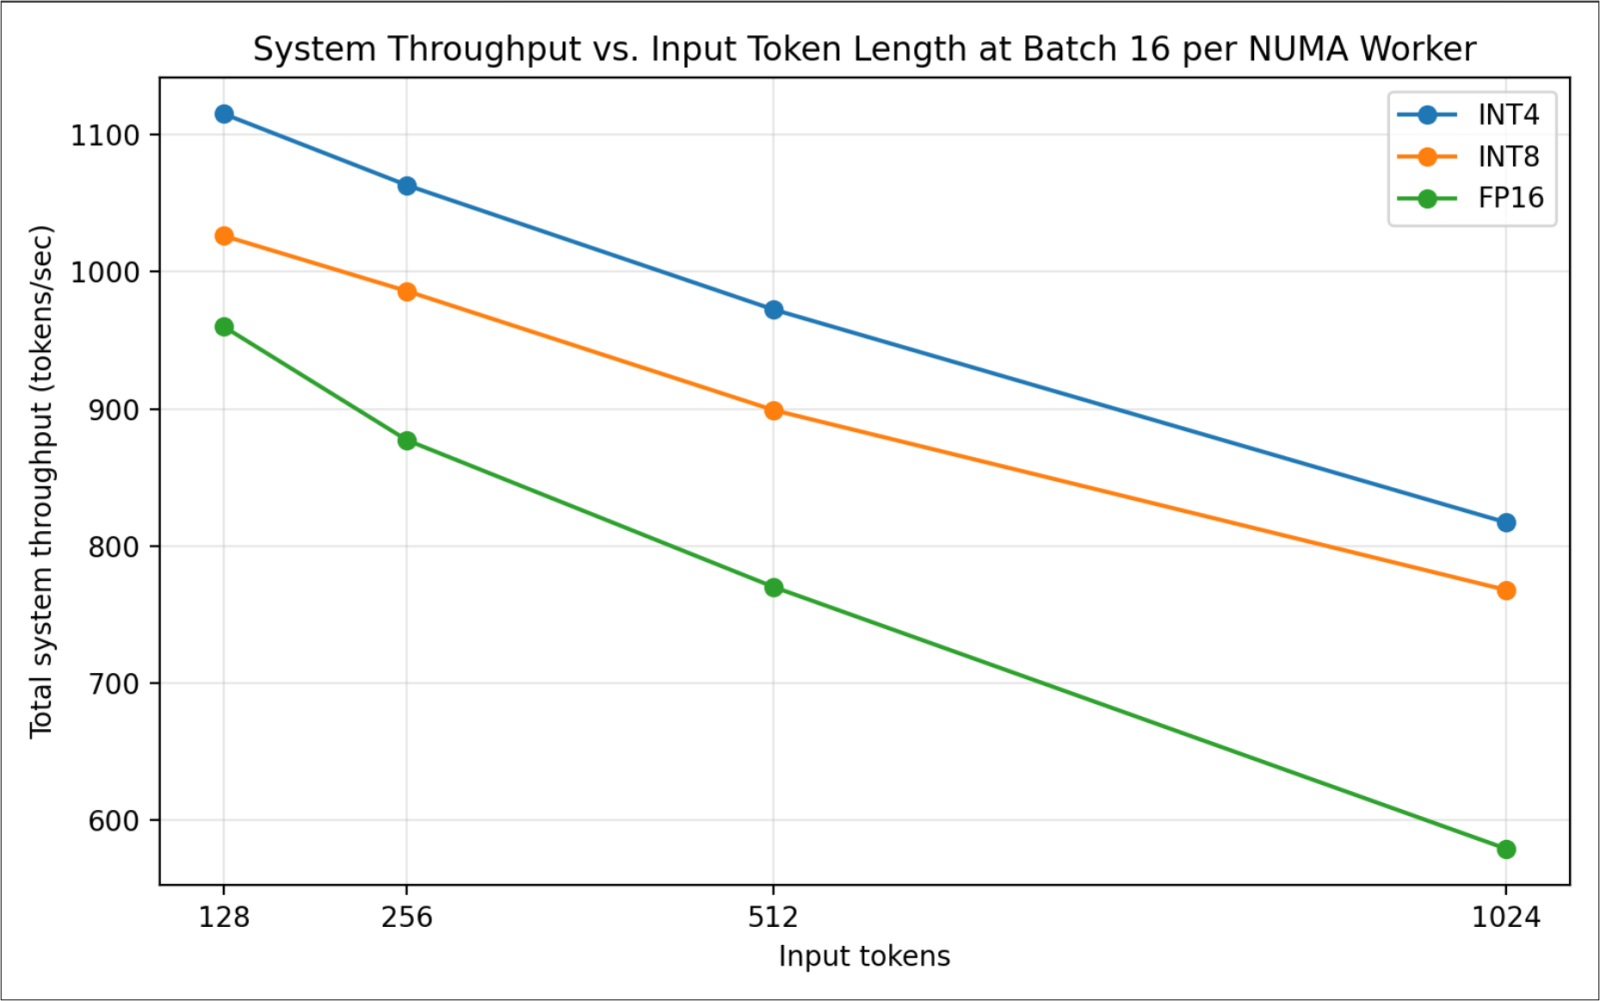
Рисунок 6. Пропускная способность системы в зависимости от длины входной последовательности при размере пакета 16 на NUMA-воркер
С увеличением длины входной последовательности общая пропускная способность системы снижается. INT4 сохраняет наивысшую пропускную способность для всех протестированных длин, далее следуют INT8 и FP16. Такое снижение является ожидаемым, поскольку более длинные промпты требуют большего объёма обработки до начала и во время генерации.
Ключевые выводы
Результаты бенчмарка позволяют сделать следующие выводы:
-
Хотя квантование INT4 обеспечивает до примерно 2,5 раза более высокую пропускную способность по сравнению с FP16 при малых размерах пакетов (и примерно в 1,3 раза выше в среднем по всей матрице рабочих нагрузок), перед развертыванием в продуктивной среде предприятиям следует отдельно оценивать точность для конкретных задач. Общедоступные результаты оценивания показывают, что современное 4-битное квантование только весов модели обычно позволяет сохранить большую часть точности в бенчмарках, однако степень её снижения зависит от метода и конкретной задачи.
-
INT8 и FP16 также обеспечили приемлемую задержку до начала ответа для протестированных рабочих нагрузок. В полном наборе результатов системного бенчмарка средний TTFT оставался ниже 200 мс для всех трёх форматов точности, что обеспечивает достаточную скорость отклика для многих интерактивных сценариев использования SLM и совместных сервисов.
-
Большие размеры пакетов повышали пропускную способность и снижали TPOT, но увеличивали TTFT. Это подтверждает ожидаемый компромисс между производительностью системы и задержкой до начала ответа. Для большинства сценариев развертывания пакеты размером от 1 до 16 на NUMA-воркер обеспечивают наиболее практичный баланс между скоростью отклика и пропускной способностью системы.
-
Более длинные входные промпты снижали пропускную способность и увеличивали время выполнения бенчмарка, особенно при больших размерах пакетов. Это подтверждает, что длину промпта необходимо учитывать при определении необходимых ресурсов системы.
Заключение
Результаты проверки инференса малых языковых моделей (SLM) на системах Lenovo ThinkAgile HX V4 и FX V4 демонстрируют, что рабочие нагрузки генеративного ИИ можно эффективно выполнять на гиперконвергентной инфраструктуре на базе CPU без необходимости использовать специализированные GPU-платформы для каждого сценария развертывания. Lenovo ThinkAgile HX V4 и FX V4 создают готовую к корпоративному использованию основу для развертывания AI-инференса на базе SLM рядом с бизнес-данными, приложениями и операционными рабочими процессами. Это позволяет шире внедрять генеративный ИИ в различных корпоративных сценариях, сохраняя при этом простоту, масштабируемость и экономическую эффективность.
Перечень компонентов: ThinkAgile HX650 V4
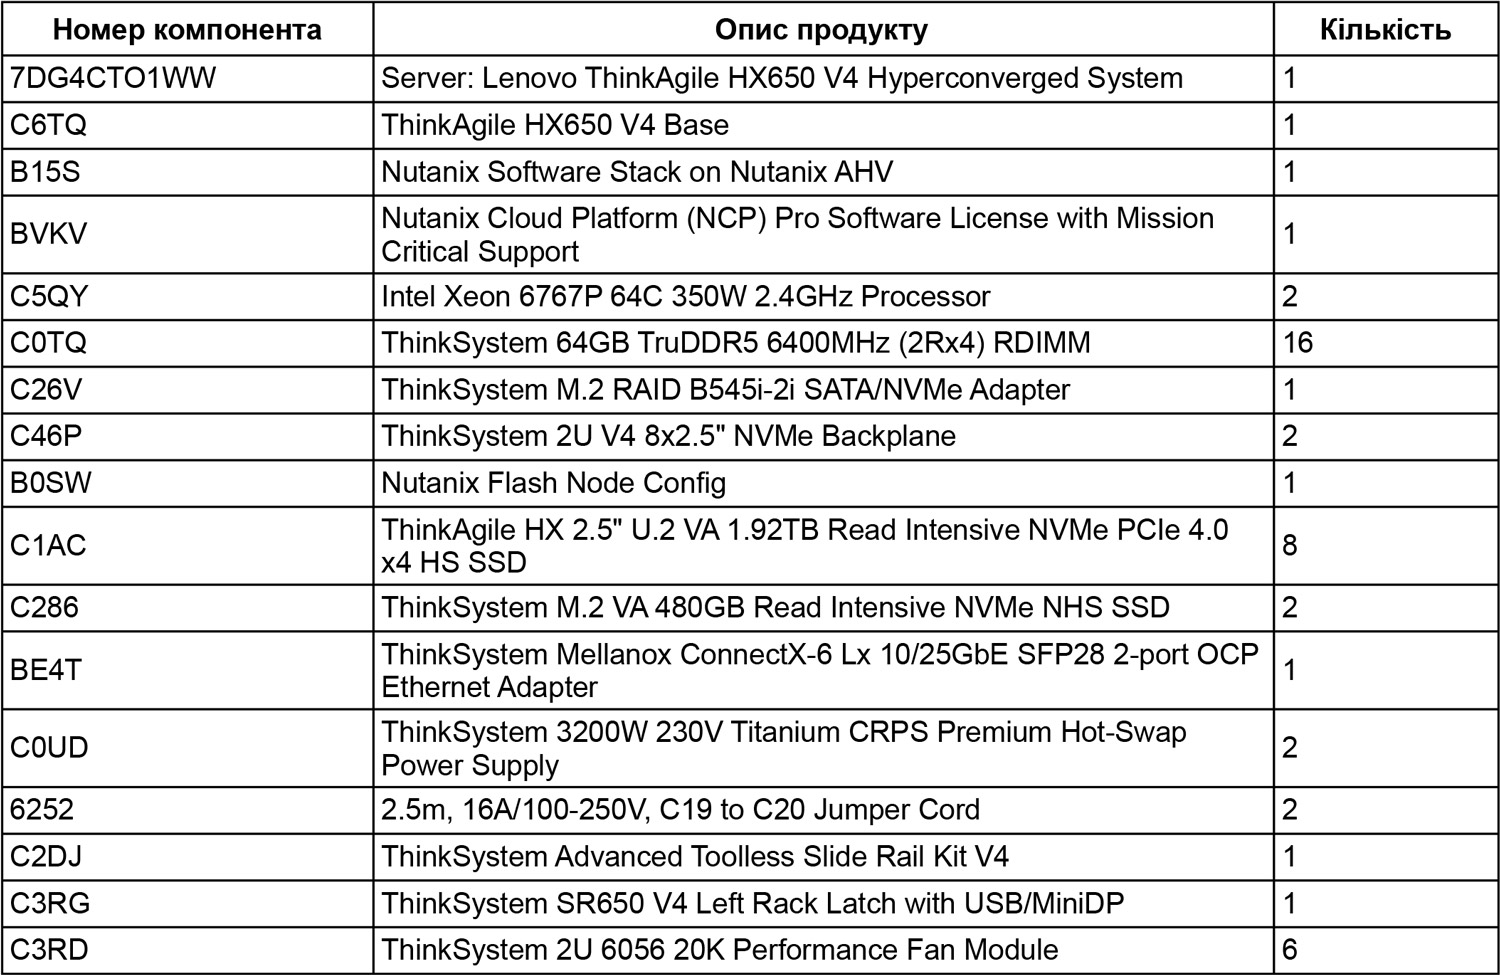
В таблице ниже приведён перечень компонентов для одного узла ThinkAgile HX650 V4 в конфигурации, проверенной в этом документе. Четыре узла с идентичной конфигурацией образовывали кластер Nutanix, описанный в таблице 1.
Таблица 8. Перечень компонентов: ThinkAgile HX650 V4
Ресурсы
Более подробную информацию можно найти в следующих материалах:
-
Lenovo ThinkAgile HX650 V4 Hyperconverged System
https://lenovopress.lenovo.com/lp2133-lenovo-thinkagile-hx650-v4-hyperconverged-system -
Lenovo ThinkAgile HX630 V4 Hyperconverged System
https://lenovopress.lenovo.com/lp2132-lenovo-thinkagile-hx630-v4-hyperconverged-system -
Lenovo ThinkAgile FX650 V4 Hyperconverged System
https://lenovopress.lenovo.com/lp2338-lenovo-thinkagile-fx650-v4-hyperconverged-system -
Lenovo ThinkAgile FX630 V4 Hyperconverged System
https://lenovopress.lenovo.com/lp2337-lenovo-thinkagile-fx630-v4-hyperconverged-system -
OpenVINO GenAI Documentation — Performance Metrics
https://openvinotoolkit.github.io/openvino.genai/docs/guides/performance-metrics/ -
OpenVINO API Documentation — openvino_genai.PerfMetrics
https://docs.openvino.ai/2025/api/genai_api/_autosummary/openvino_genai.PerfMetrics.html -
OpenVINO API Documentation — openvino_genai.LLMPipeline
https://docs.openvino.ai/2025/api/genai_api/_autosummary/openvino_genai.LLMPipeline.html -
OpenVINO GenAI Documentation
https://openvinotoolkit.github.io/openvino.genai/ -
Microsoft Phi-3 Model Collection — Hugging Face
https://huggingface.co/collections/microsoft/phi-3 -
Microsoft Phi-3 Mini 128K Instruct — Hugging Face Model Card
https://huggingface.co/microsoft/Phi-3-mini-128k-instruct -
OpenVINO Phi-3 Mini 128K Instruct INT4 Model — Hugging Face
https://huggingface.co/OpenVINO/Phi-3-mini-128k-instruct-int4-ov -
Intel AI Development Software
https://www.intel.com/content/www/us/en/developer/topic-technology/artificial-intelligence/development-software.html
Автор
Cristian Ghetau – инженер-консультант Lenovo в Румынии, имеет опыт работы с технологиями облачной инфраструктуры. Более 13 лет работает с виртуальными средами VMware, Microsoft, Oracle и Linux.
Связанные семейства продуктов
С этим документом связаны следующие семейства продуктов:
Товарные знаки
Lenovo и логотип Lenovo являются товарными знаками или зарегистрированными товарными знаками Lenovo в США, других странах или одновременно в США и других странах. Текущий список товарных знаков Lenovo доступен в Интернете по адресу https://www.lenovo.com/us/en/legal/copytrade/
Ниже приведённые названия являются товарными знаками Lenovo в США, других странах или одновременно в США и других странах:
Lenovo®
ThinkAgile®
ThinkSystem®
Ниже приведённые названия являются товарными знаками других компаний:
Intel®, логотип Intel, OpenVINO® и Xeon® являются товарными знаками Intel Corporation или её дочерних компаний.
Linux® является товарным знаком Linus Torvalds в США и других странах.
Microsoft® является товарным знаком Microsoft Corporation в США, других странах или одновременно в США и других странах.
Другие названия компаний, продуктов или сервисов могут быть товарными знаками или знаками обслуживания соответствующих владельцев.
© 2026 Lenovo. Все права защищены.